JUC

学习视频:
【狂神说Java】JUC并发编程最新版通俗易懂_哔哩哔哩_bilibili

1. 基本介绍

  • JUC:java.util.concurrent 包,简称 JUC,是 Java 5 引入的并发工具包,提供了大量的并发编程工具和高级特性,用于简化多线程编程
  • 进程和线程:
    • 进程:计算机中正在执行的独立程序,每个进程拥有独立的内存空间和系统资源,进程是CPU资源分配的最小单位
    • 线程:进程内部的执行单元,一个进程可以包含多个线程,线程共享进程的内存空间和资源,线程是CPU调度和执行的最小单位
      • Java 默认有2个线程 ==> main线程、GC线程
  • Java 真的可以开启线程?
    • 从源码看,Java 是使用本地 native 方法调用底层的 C/C++ 代码来开启线程
    • start0 是 Thread 类的私有本地方法,由 JVM 通过 C/C++ 代码实现
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// C++ 底层, Java是没有权限操作底层硬件的
private native void start0();

public synchronized void start() {
if (threadStatus != 0)
throw new IllegalThreadStateException();
group.add(this);
boolean started = false;
try {
start0(); // 本地方法,实际启动线程
started = true;
} finally {
try {
if (!started) {
group.threadStartFailed(this);
}
} catch (Throwable ignore) {

}
}
}
  • 并发和并行:并发编程的本质:充分利用CPU的资源!

    • 并发:在单核处理器上模拟出多条线程,任务通过操作系统的调度,轮流占用CPU时间片,从宏观上看似乎是同时进行(多线程操作同一个资源)
    • 并行:在多核处理器上,多个任务可以真正同时在不同的处理器核心上运行,可以使用线程池提高性能
    1
    2
    3
    4
    5
    6
    public class Test1 {
    public static void main(String[] args) {
    //获取cpu的核数
    System.out.println(Runtime.getRuntime().availableProcessors());
    }
    }
  • 多线程 是实现并发的一种方式,通过并发(交替或同时)执行多个线程实现

  • Java 中线程的 6 种状态:NEW,RUNNABLE,BLOCKED,WAITING,TIMED_WAITING,TERMINATED

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
public enum State {
// 新生
NEW,

// 运行
RUNNABLE,

// 阻塞
BLOCKED,

// 等待
WAITING,

// 超时等待
TIMED_WAITING,

// 终止
TERMINATED;
}

2. wait 和 sleep 的区别

  • 来自不同的类:
    • wait => Object
    • sleep => Thread

一般情况企业中使用休眠是:

1
2
3
// 来自 java.util.concurrent 包下的 TimeUnit 类
TimeUnit.DAYS.sleep(1); // 休眠1天
TimeUnit.SECONDS.sleep(1); // 休眠1s
  • 关于锁的释放:
    • wait 会释放锁对象,使其他等待该锁的线程能够获得锁并继续执行
    • sleep 不会释放锁 ==> 抱着锁睡觉
  • 使用的范围不同:
    • wait 必须在同步方法/同步代码块中调用,否则会抛出 IllegalMonitorStateException 异常
    • sleep 可以在任何地方睡
  • 是否需要捕获异常:
    • 都需要捕获 InterruptedException 异常

3. Lock 锁(重点)

3.1 传统的 Synchronized 锁

  • 减少耦合:线程就是一个单独的资源类,没有任何的附属操作!
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
/**
* 真正的多线程开发
* 线程就是一个单独的资源类,没有任何的附属操作!
*/
public class SaleTicketDemo01 {
public static void main(String[] args) {
// 多线程操作
// 并发:多线程操作同一个资源类,把资源类丢入线程
Ticket ticket = new Ticket();

// Runnable 是 @FunctionalInterface 函数式接口
// jdk1.8 之后使用 lambda 表达式
new Thread(() -> {
for (int i = 0; i < 40; i++) {
ticket.sale();
}
}, "A").start();
new Thread(() -> {
for (int i = 0; i < 40; i++) {
ticket.sale();
}
}, "B").start();
new Thread(() -> {
for (int i = 0; i < 40; i++) {
ticket.sale();
}
}, "C").start();
}
}

// 资源类: 属性+方法 oop思想
class Ticket {
private int number = 50;

// 卖票的方式
// synchronized 本质:队列+锁
public synchronized void sale() {
if (number > 0) {
System.out.println(Thread.currentThread().getName() + " 卖出了第 " + (number--) + " 张票,剩余:" + number + " 张票");
}
}
}

3.2 Lock 锁

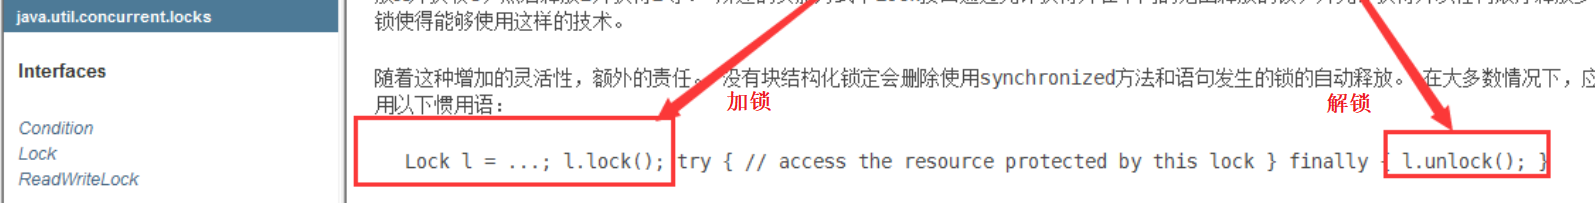
  • 加锁解锁:lock()、unlock()

image-20240509203720427

  • 3个实现类:
    • ReentrantLock: 可重入锁
    • ReentrantReadWriteLock.ReadLock: 可重入读锁
    • ReentrantReadWriteLock.WriteLock: 可重入写锁
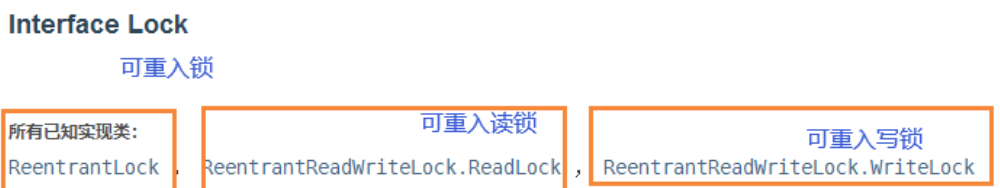
image-20240509203744318

  • 公平锁与非公平锁:
    • 公平锁: 必须先来后到
    • 非公平锁: 可以插队**(默认为非公平锁)**
  • 使用 Lock 的三步曲:
    • 创建 Lock 对象:Lock lock = new ReentrantLock();
    • 加锁:lock.lock();
    • 解锁:在 finally 块中解锁 lock.unlock();
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
public class SaleTicketDemo02 {
public static void main(String[] args) {
//多线程操作
//并发:多线程操作同一个资源类,把资源类丢入线程
Ticket2 ticket = new Ticket2();
new Thread(() -> {
for (int i = 0; i < 40; i++) ticket.sale();
}, "A").start();
new Thread(() -> {
for (int i = 0; i < 40; i++) ticket.sale();
}, "B").start();
new Thread(() -> {
for (int i = 0; i < 40; i++) ticket.sale();
}, "C").start();
}
}

// lock三部曲
// 1. Lock lock=new ReentrantLock();
// 2. lock.lock() 加锁
// 3. finally=> 解锁:lock.unlock();
class Ticket2 {
private int number = 50;

Lock lock = new ReentrantLock();

//卖票的方式
// 使用Lock 锁
public void sale() {
//加锁
lock.lock();
try {
//业务代码
if (number > 0) {
System.out.println(Thread.currentThread().getName() + " 卖出了第" + (number--) + " 张票,剩余:" + number + " 张票");
}
} catch (Exception e) {
e.printStackTrace();
} finally {
//解锁
lock.unlock();
}
}
}

3.3 Synchronized VS. Lock

  • 锁的实现:

    • Synchronized:内置的 Java 关键字,直接由 JVM 实现
    • Lock:接口,由 Java 类实现,需要显式调用 lock 和 unlock 方法
  • 获取锁状态:

    • Synchronized:无法判断获取锁的状态
    • Lock: 可以通过 tryLock 方法判断是否成功获得锁
  • 锁的释放:

    • Synchronized: 出了同步块或方法范围后,自动释放锁
    • Lock:需要手动加锁和手动释放锁,如果没有释放锁,可能会导致死锁
  • 锁等待行为:

    • Synchronized:线程1获得锁,线程2必须等待,直到线程1释放锁

    • Lock:可以通过 tryLock 方法尝试获取锁,不会导致长时间等待

  • 可重入性:又称递归锁,指一个线程在持有锁的情况下可以再次获取该锁的能力;当一个线程已经获得了某个锁,可以再次获取该锁而不会被阻塞;每次获取锁的计数增加 1,每次释放锁的计数减少 1,直到计数为 0 时,锁才真正被释放

    • Synchronized:是可重入锁,不可以中断的,非公平的
    • Lock:ReentrantLock 实现了可重入锁,可以判断锁,可以自己设置公平锁和非公平锁
  • 使用场景:

    • Synchronized:适合锁定少量代码的同步问题
    • Lock:适合锁定大量同步代码的复杂场景

锁到底是什么? 如何判断锁的是谁?

  • 锁: 一种并发控制机制,用于协调多个线程对共享资源的访问,确保数据的正确性和一致性
  • 锁的粒度:锁可以锁定方法、代码块或对象实例
  • 锁的持有者:可以使用调试工具或日志记录来判断哪个线程当前持有锁

4. 生产者和消费者问题-线程通信

面试常考:单例模式、排序算法、生产者和消费者、死锁

4.1 Synchronized 版

  • wait、notify 和 notifyAll 的使用中必须谨防虚假唤醒
  • 虚假唤醒:多线程环境下,有多个线程执行了wait()方法,需要其他线程执行notify()或者notifyAll()方法去唤醒它们,假如多个线程都被唤醒了,但是只有其中一部分是有用的唤醒操作,其余的唤醒都是无用功;对于不应该被唤醒的线程而言,便是虚假唤醒
  • 防止虚假唤醒问题:wait 方法的调用应该始终放在循环(while)中,而不是条件判断(if)中
    • 当某个线程被错误地唤醒后,如果使用 if 判断条件,线程会继续执行,而不是重新检查条件是否满足,导致逻辑错误

目前只有 A 和 B 两个线程,一个 +1,一个 -1,用 if 不会出问题,但是如果增加 C 和 D 线程,就会变成两个 +1,两个 -1,此时用 if ,可能会出现问题,如:

A先执行,执行时调用了wait方法,那它会等待,此时会释放锁,如果线程C获得锁并且也会执行wait方法,两个加线程一起等待被唤醒,此时减线程中的某一个线程执行完毕并且唤醒了这俩加线程,那么A获取了锁并且加1,执行完毕之后B再执行,如果是if的话,那么A修改完num后,B不会再去判断num的值,直接会给num+1。如果是while的话,A执行完之后,B还会去判断num的值,因此就不会执行

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
/**
* 线程之间的通信问题: 生产者和消费者问题 等待唤醒、通知唤醒
* 线程交替执行 A B 操作同一个变量
*/
public class A {
public static void main(String[] args) {
Data data = new Data();

// 线程操作资源类, 降低耦合
new Thread(() -> {
for (int i = 0; i < 10; i++) {
try {
data.increment();
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}, "A").start();
new Thread(() -> {
for (int i = 0; i < 10; i++) {
try {
data.decrement();
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}, "B").start();
}
}

// 判断等待 => 业务 => 通知
class Data { // 数字 资源类
private int number = 0;

// +1
public synchronized void increment() throws InterruptedException {
while (number != 0) {
// 等待操作
this.wait();
}
number++;
System.out.println(Thread.currentThread().getName() + "=>" + number);
// 通知其他线程 我+1完毕了
this.notifyAll();
}

// -1
public synchronized void decrement() throws InterruptedException {
while (number == 0) {
// 等待操作
this.wait();
}
number--;
System.out.println(Thread.currentThread().getName() + "=>" + number);
// 通知其他线程 我-1完毕了
this.notifyAll();
}
}

4.2 Lock 版

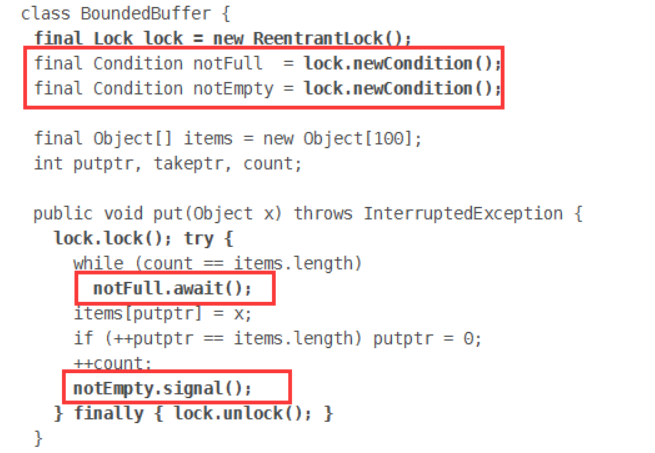
  • 对应于 synchronized,JUC 版本下,Lock 锁也有对应的唤醒与停止方法,分别是 condition接口下的signal()与await()
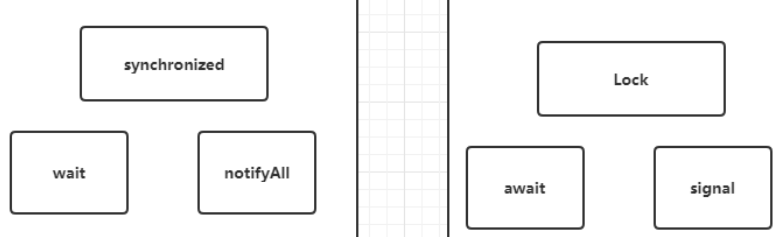
image-20240510113250698

image-20240510113305892

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
public class B {
public static void main(String[] args) {
Data2 data = new Data2();

new Thread(()->{for(int i=0;i<10;i++) {
data.increment();
}
},"A").start();
new Thread(()->{for(int i=0;i<10;i++) {
data.decrement();
}},"B").start();
new Thread(()->{for(int i=0;i<10;i++) {
data.increment();
}
},"C").start();
new Thread(()->{for(int i=0;i<10;i++) {
data.decrement();
}
},"D").start();
}
}
class Data2{
//数字 资源类
private int number = 0;

//lock锁
Lock lock = new ReentrantLock();
Condition condition = lock.newCondition();

//+1
public void increment() {
lock.lock();
try{

//业务
while (number!=0){
//等待操作
condition.await();
}
number++;
System.out.println(Thread.currentThread().getName()+"=>"+number);
//通知其他线程 我+1完毕了
condition.signalAll();
} catch (Exception e) {
e.printStackTrace();
} finally {
lock.unlock();
}
}

//-1
public void decrement() {
lock.lock();
try{
//业务
while (number==0){
//等待操作
condition.await();
}
number--;
System.out.println(Thread.currentThread().getName()+"=>"+number);
//通知其他线程 我+1完毕了
condition.signalAll();
} catch (Exception e) {
e.printStackTrace();
} finally {
lock.unlock();
}
}
}
  • Condition 的优势?
    • 可以实现精准的通知和唤醒线程,如:在A线程执行完后精准唤醒B线程执行,B线程执行完后精准唤醒C线程执行,C线程执行完后精准唤醒A线程执行
    • 线程 A: 其他同理
      • 通过 condition1.await() 等待 number 变为 1。
      • 打印 AAAAA,设置 number 为 2,唤醒 condition2 上的等待线程(B)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
/**
* A 执行完 调用B
* B 执行完 调用C
* C 执行完 调用A
*/
public class C {

public static void main(String[] args) {
Data3 data3 = new Data3();
new Thread(() -> {
for (int i = 0; i < 10; i++) {
data3.printA();
}
}, "A").start();
new Thread(() -> {
for (int i = 0; i < 10; i++) {
data3.printB();
}
}, "B").start();
new Thread(() -> {
for (int i = 0; i < 10; i++) {
data3.printC();
}
}, "C").start();
}
}

class Data3 { // 资源类
private Lock lock = new ReentrantLock();
private Condition condition1 = lock.newCondition();
private Condition condition2 = lock.newCondition();
private Condition condition3 = lock.newCondition();
private int number = 1; // 1A 2B 3C

public void printA() {
lock.lock();
try {
// 判断 -> 执行 -> 通知
while (number != 1) {
//等待
condition1.await();
}

// 执行
System.out.println(Thread.currentThread().getName() + ",AAAAA");

// 唤醒指定的线程
number = 2;
condition2.signal(); // 唤醒2
} catch (Exception e) {
e.printStackTrace();
} finally {
lock.unlock();
}
}

public void printB() {
lock.lock();
try {
// 判断 -> 执行 -> 通知
while (number != 2) {
condition2.await();
}
System.out.println(Thread.currentThread().getName() + ",BBBBB");
// 唤醒3
number = 3;
condition3.signal();
} catch (Exception e) {
e.printStackTrace();
} finally {
lock.unlock();
}
}

public void printC() {
lock.lock();
try {
// 判断 -> 执行 -> 通知
while (number != 3) {
condition3.await();
}
System.out.println(Thread.currentThread().getName() + ",CCCCC");
// 唤醒1
number = 1;
condition1.signal();
} catch (Exception e) {
e.printStackTrace();
} finally {
lock.unlock();
}
}
}

5. 8锁现象

  • 如何判断锁锁的到底是谁?
    • 锁: 线程同步的机制,用来确保多个线程能够安全访问共享资源
    • 锁的是谁:
      • 实例方法的锁: 锁的是调用方法的实例对象
      • 静态方法的锁: 锁的是该类的 Class 对象
  • 从 8 个锁相关问题深刻理解锁

5.1 一对象,两同步

同一个对象,两个同步方法,标准情况下是先发短信还是打电话

  • 问题: 两个同步实例方法 sendSms 和 call,哪个先执行?
  • 结论: 先发短信,再打电话,因为两个方法用的是同一个锁
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
/**
* 8锁,就是关于锁的8个问题
* 1. 标准情况下是先发短信还是打电话
*/
public class Test1 {
public static void main(String[] args) {
Phone phone = new Phone();
new Thread(() -> phone.sendSms(), "A").start();
new Thread(() -> phone.call(), "B").start();
}
}

class Phone {
// synchronized 锁的对象是方法的调用者
// 两个方法用的是同一个锁, 谁先拿到谁先执行
public synchronized void sendSms() {
try {
TimeUnit.SECONDS.sleep(1);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("sendSms");
}

public synchronized void call() {
System.out.println("call");
}
}

5.2 一对象,两同步,延迟4s

同一个对象,两个同步方法

  • 问题: 如果 sendSms 方法延迟 4 秒,哪个先执行?
  • 结论: 还是先发短信,再打电话,因为两个方法用的是同一个锁
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
class Phone {
// 同步实例方法,锁的对象是调用者
public synchronized void sendSms() {
try {
TimeUnit.SECONDS.sleep(4);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("sendSms");
}

public synchronized void call() {
System.out.println("call");
}
}

public class Test1 {
public static void main(String[] args) {
Phone phone = new Phone();
new Thread(() -> phone.sendSms(), "A").start();
try {
TimeUnit.SECONDS.sleep(1);
} catch (InterruptedException e) {
e.printStackTrace();
}
new Thread(() -> phone.call(), "B").start();
}
}

5.3 一对象,一同步,一普通

同一个对象,一个同步方法,一个普通方法

  • 问题: 如果增加一个普通方法 hello,是先执行发短信还是 hello?

  • 结论: 先执行 hello,再执行发短信,因为普通方法没有锁,不受同步方法的影响

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
class Phone2 {
public synchronized void sendSms() {
try {
TimeUnit.SECONDS.sleep(4);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("sendSms");
}

public synchronized void call() {
System.out.println("call");
}

// 普通方法
public void hello() {
System.out.println("hello");
}
}

public class Test2 {
public static void main(String[] args) {
Phone2 phone = new Phone2();
new Thread(() -> phone.sendSms(), "A").start();
try {
TimeUnit.SECONDS.sleep(1);
} catch (InterruptedException e) {
e.printStackTrace();
}
new Thread(() -> phone.hello(), "B").start();
}
}

5.4 两对象,两同步

两个对象,两个同步方法

  • 问题: 两个不同的对象,分别调用同步方法 call 和 sendSms,哪个先执行?
  • 结论: 先打电话,再发短信,因为两个不同的对象对应不同的锁
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
class Phone2 {
public synchronized void sendSms() {
try {
TimeUnit.SECONDS.sleep(4);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("sendSms");
}

public synchronized void call() {
System.out.println("call");
}

public void hello() {
System.out.println("hello");
}
}

public class Test2 {
public static void main(String[] args) {
Phone2 phone = new Phone2();
Phone2 phone2 = new Phone2();
new Thread(() -> phone.sendSms(), "A").start();
try {
TimeUnit.SECONDS.sleep(1);
} catch (InterruptedException e) {
e.printStackTrace();
}
new Thread(() -> phone2.call(), "B").start();
}
}

5.5 一对象,两静态同步

一个对象,两个静态同步方法

  • 问题: 如果修改为两个静态同步方法,哪个先执行?
  • 结论: 先发短信,再打电话,因为两个方法用的是同一个锁,即 Class 对象
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
class Phone3 {
public static synchronized void sendSms() {
try {
TimeUnit.SECONDS.sleep(4);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("sendSms");
}

public static synchronized void call() {
System.out.println("call");
}
}

public class Test3 {
public static void main(String[] args) {
Phone3 phone = new Phone3();
new Thread(() -> phone.sendSms(), "A").start();
try {
TimeUnit.SECONDS.sleep(1);
} catch (InterruptedException e) {
e.printStackTrace();
}
new Thread(() -> phone.call(), "B").start();
}
}

5.6 两对象,两静态同步

两个对象,两个静态同步方法

  • 问题: 两个不同的对象,分别调用静态同步方法 sendSms 和 call,哪个先执行?
  • 结论:先发短信,再打电话,因为静态方法锁的是 Class 对象,两个对象共享一个 Class 锁
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
class Phone3 {
public static synchronized void sendSms() {
try {
TimeUnit.SECONDS.sleep(4);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("sendSms");
}

public static synchronized void call() {
System.out.println("call");
}
}

public class Test3 {
public static void main(String[] args) {
Phone3 phone = new Phone3();
Phone3 phone2 = new Phone3();
new Thread(() -> phone.sendSms(), "A").start();
try {
TimeUnit.SECONDS.sleep(1);
} catch (InterruptedException e) {
e.printStackTrace();
}
new Thread(() -> phone2.call(), "B").start();
}
}

5.7 一对象,一同步,一静态同步

一个对象,一个静态同步方法,一个普通同步方法

  • 问题: 同一个对象上调用静态同步方法 sendSms 和普通同步方法 call,哪个先执行?
  • 结论: 先打电话,再发短信,因为静态同步方法和普通同步方法锁定的是不同的对象,一个是 Class 对象,一个是实例对象
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
class Phone4 {
public static synchronized void sendSms() {
try {
TimeUnit.SECONDS.sleep(4);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("sendSms");
}

public synchronized void call() {
System.out.println("call");
}
}

public class Test4 {
public static void main(String[] args) {
Phone4 phone = new Phone4();
new Thread(() -> phone.sendSms(), "A").start();
try {
TimeUnit.SECONDS.sleep(1);
} catch (InterruptedException e) {
e.printStackTrace();
}
new Thread(() -> phone.call(), "B").start();
}
}

5.8 两对象,一同步,一静态同步

两个对象,一个静态同步方法,一个普通的同步方法

  • 问题: 两个不同的对象,分别调用静态同步方法 sendSms 和普通同步方法 call,哪个先执行?
  • 结论: 还是先打电话,再发短信,因为静态同步方法和普通同步方法锁定的是不同的对象,一个是 Class 对象,一个是实例对象
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
class Phone4 {
public static synchronized void sendSms() {
try {
TimeUnit.SECONDS.sleep(4);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("sendSms");
}

public synchronized void call() {
System.out.println("call");
}
}

public class Test4 {
public static void main(String[] args) {
Phone4 phone = new Phone4();
Phone4 phone2 = new Phone4();
new Thread(() -> phone.sendSms(), "A").start();
try {
TimeUnit.SECONDS.sleep(1);
} catch (InterruptedException e) {
e.printStackTrace();
}
new Thread(() -> phone2.call(), "B").start();
}
}

6. 线程不安全的集合类

6.1 List

  • 并发修改异常: ArrayList 在多线程并发修改下不安全,可能会导致 ConcurrentModificationException
  • 解决方案:
    • 使用 Vector:
      • Vector 是早期集合框架的一部分,实现了线程安全
      • 内部方法大多通过 synchronized 关键字同步,但性能较低
    • 使用 Collections.synchronizedList:
      • 提供线程安全的 List 封装
      • 通过内部的同步代码块实现安全性
    • 使用 CopyOnWriteArrayList:写入时复制! COW 计算机程序设计领域的一种优化策略
      • 高效的线程安全 List 实现
      • 读写分离,写操作时复制整个底层数组,写入效率较低但读取效率高
        • 写操作:
          • 每次写操作都会复制整个数组,保证写入操作的原子性
          • 使用 ReentrantLock 锁实现线程安全
        • 读操作:
          • 读取操作不加锁,使用数组副本提供一致性读
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
import java.util.*;
import java.util.concurrent.CopyOnWriteArrayList;

/**
* java.util.ConcurrentModificationException 并发修改异常
*/
public class ListTest {
public static void main(String[] args) {
// 并发下 ArrayList 不安全的
/**
* 解决方案:
* 1、List<String> list = new Vector<>();
* 2、List<String> list = Collections.synchronizedList(new ArrayList<>());
* 3、List<String> list = new CopyOnWriteArrayList<>();
*/
// CopyOnWrite 写入时复制 COW 计算机程序设计领域的一种优化策略
// 多个线程调用的时候,list,读取的时候固定的,写入(覆盖)
// 在写入的时候避免覆盖,造成数据问题!
// 读写分离
// CopyOnWriteArrayList 比Vector 好在哪里?(看源码)
// vector底层运用大量的synchronized关键字,而CopyOnWriteArrayList底层运用的是ReentrantLock锁
List<String> list = new CopyOnWriteArrayList<>();
for (int i = 0; i < 2000; i++) {
new Thread(()->{
list.add(UUID.randomUUID().toString().substring(0, 5));
System.out.println(list);
},String.valueOf(i)).start();
}
}
}
  • 性能对比:

    • Vector 性能较低的原因:
      • 每个方法都使用 synchronized 关键字锁定整个对象,导致锁争用严重,特别是在多线程环境下。
      • 无论读写操作,均需获取锁,降低了并发性能。
    • Collections.synchronizedList:
      • 使用独立的锁对象,避免锁定整个 List 对象。
      • 提供线程安全的 List 封装,通过内部的同步代码块实现安全性。

    Vector 与 Collections.synchronizedList 在性能上差异较小,因为都使用 synchronized 关键字同步

    • CopyOnWriteArrayList 性能较高的原因:
      • 读写分离,读操作无需加锁,写操作时使用 ReentrantLock 锁实现线程安全。
      • 适用于读多写少的场景,提高了读取性能。

6.2 Set

  • HashSet 的底层就是 HashMap,都是线程不安全的,也就是在在多线程环境下可能会出现 ConcurrentModificationException 或数据丢失等问题
  • 解决方案:
    • Collections.synchronizedSet:
      • 使用 Collections 工具类提供线程安全封装
      • 通过内部的同步代码块保证线程安全
    • CopyOnWriteArraySet:
      • 基于 CopyOnWriteArrayList 实现的线程安全 Set
      • 读写分离,读操作无需加锁,写操作复制底层数组
      • 适用于读多写少的场景
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
import java.util.concurrent.CopyOnWriteArraySet;

/**
* 同理可证:ConcurrentModificationException
* 1、Set<String> set = Collections.synchronizedSet(new HashSet<>());
* 2、Set<String> set = new CopyOnWriteArraySet<>();
*/
public class SetTest {
public static void main(String[] args) {
Set<String> set = new HashSet<>();
// Set<String> set = Collections.synchronizedSet(new HashSet<>());
// Set<String> set = new CopyOnWriteArraySet<>();

for (int i = 1; i <= 30; i++) {
new Thread(()->{
set.add(UUID.randomUUID().toString().substring(0, 5));
System.out.println(set);
},String.valueOf(i)).start();
}
}
}

6.3 Map

  • HashMap 是线程不安全的
  • 解决方案:
    • Hashtable:
      • 早期集合框架中的线程安全 Map 实现
      • 内部通过 synchronized 关键字同步
      • 性能较低,因为所有方法都需要获取锁
    • Collections.synchronizedMap:
      • 使用 Collections 工具类提供线程安全封装
      • 内部通过同步代码块实现线程安全
    • ConcurrentHashMap:
      • JUC 包中提供的高效线程安全 Map 实现
      • 使用分段锁定技术,允许更高的并发度
1
2
3
4
5
6
7
8
9
10
11
12
public class MapTest {
public static void main(String[] args) {
// 使用 ConcurrentHashMap
Map<String, String> map = new ConcurrentHashMap<>();
for (int i = 1; i <= 30; i++) {
new Thread(() -> {
map.put(Thread.currentThread().getName(), UUID.randomUUID().toString().substring(0, 5));
System.out.println(map);
}, String.valueOf(i)).start();
}
}
}

6.4 总结

  • 线程安全集合的选择:
    • List: Collections.synchronizedList, CopyOnWriteArrayList
    • Set: Collections.synchronizedSet, CopyOnWriteArraySet
    • Map: Collections.synchronizedMap, ConcurrentHashMap
  • 线程安全集合框架对比:
集合类型 线程安全性 锁机制 读操作性能 写操作性能
ArrayList 线程不安全 无 高 高
Vector 线程安全 synchronized同步方法 低 低
Collections.synchronizedList 线程安全 synchronized同步代码块 低 低
CopyOnWriteArrayList 线程安全 ReentrantLock 高 中(复制成本)
HashSet 线程不安全 无 高 高
Collections.synchronizedSet 线程安全 synchronized 低 低
CopyOnWriteArraySet 线程安全 ReentrantLock 高 中(复制成本)
HashMap 线程不安全 无 高 高
Hashtable 线程安全 synchronized 低 低
Collections.synchronizedMap 线程安全 synchronized 低 低
ConcurrentHashMap 线程安全 分段锁定(ReentrantLock) 高 高

7. Callable 接口

  • 类似 Runnable 接口,但 Callable 接口:

    • 可以有返回值,可以抛出异常

    • 重写的方法不同,Runnable 是 run(),而 Callable 是 call()

  • 如何启动 Callable?

    • FutureTask 接受一个 Callable 实现,作为适配器,使其可以作为 Runnable 传递给 Thread 构造器
    • 原理:FutureTask 实现了 Runnable 接口的子接口RunnableFuture,FutureTask 有一个带 Callable 类型参数的构造器,所以 FutureTask 可以作为 Runnable 接口的实现类传到 Thread 的构造器中
  • 结果缓存机制:

    • FutureTask 通过内部状态 state 管理任务的执行和结果缓存,共有 5 种状态:
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    private volatile int state;
    // NEW: 初始状态,任务未启动
    private static final int NEW = 0;
    // COMPLETING: 任务正在完成中
    private static final int COMPLETING = 1;
    // NORMAL: 任务成功完成
    private static final int NORMAL = 2;
    // EXCEPTIONAL: 任务抛出了异常
    private static final int EXCEPTIONAL = 3;
    // CANCELLED: 任务被取消
    private static final int CANCELLED = 4;
    // INTERRUPTING/INTERRUPTED: 任务正在被中断
    private static final int INTERRUPTING = 5;
    private static final int INTERRUPTED = 6;
    • 源码分析:
      • FutureTask 的 run() 方法负责执行 Callable,并在执行后保存结果
      • 只有当 state 为 NEW 时才会执行任务,否则直接返回
      • 执行过程中会将 state 更新为 COMPLETING,然后再更新为 NORMAL 或 EXCEPTIONAL
    • 当一个 Callable 被 FutureTask 包装后,任务执行后会缓存其结果,避免重复执行
  • FutureTask 线程安全机制:

    • CAS: 使用 Unsafe 类的 CAS 操作保证状态变更的原子性
    • 锁: 使用 ReentrantLock 锁控制任务执行和结果获取的同步
  • 阻塞调用:

    • get() 方法会阻塞等待任务完成,如果任务已经完成,则直接返回结果(缓存机制)
    • 可以使用异步方式获取结果,例如结合 ExecutorService
  • 代码示例:为什么结果只打印出了一个 call() ?

    • 线程 A:
      • 首次启动 Thread,执行 futureTask.run()
      • state 为 NEW,成功进入执行逻辑
      • 执行 call() 方法,打印 “call()” 并返回结果
      • 更新 state 为 NORMAL,缓存结果
    • 线程 B:
      • 启动 Thread,再次执行 futureTask.run()
      • state 已经是 NORMAL(或其他非 NEW 状态),直接返回
      • 任务没有被再次执行
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
public class CallableTest {
public static void main(String[] args) throws ExecutionException, InterruptedException {
MyThread thread = new MyThread();
FutureTask futureTask = new FutureTask(thread);// 适配类

new Thread(futureTask,"A").start();
new Thread(futureTask,"B").start(); //结果会被缓存,效率高

String o = (String)futureTask.get(); //获取Callable的返回结果; 这个get方法可能会产生阻塞!把它放在最后
// FutureTask.get()是一个阻塞调用,它会等待直到任务完成才能返回结果。这就是为什么在多线程编程中,我们通常使用FutureTask或者类似的任务,以便在后台线程上执行长时间运行的任务,而不会阻塞主线程。

//或者使用异步通信来处理!
System.out.println(o);
}
}

class MyThread implements Callable<String> {
@Override
public String call(){
System.out.println("call()");
return "fsaf";
}
}
  • 如果希望两个线程都能执行 call(),需要为每个线程创建独立的 FutureTask 实例:
1
2
3
4
5
FutureTask<String> futureTask1 = new FutureTask<>(thread);
FutureTask<String> futureTask2 = new FutureTask<>(thread);

new Thread(futureTask1, "A").start();
new Thread(futureTask2, "B").start();

8. 常用的辅助类

8.1 CountDownLatch

组团插队

  • 作用:允许一组线程等待另一组线程完成特定任务之后再继续执行,可以用于线程之间的协调和同步
    • 可以看作一个减法计数器,当计数器归零时,所有等待的线程被唤醒
  • 主要方法
    • countDown():
      • 将计数器减 1
      • 当计数器变为 0 时,所有阻塞在 await() 方法的线程将被唤醒
    • await():使当前线程阻塞,直到计数器归零就唤醒,再继续向下运行
  • 使用限制:
    • 一次性工具: 不能复用
    • 计数器不可重置: 每次需要新的 CountDownLatch 实例
  • 代码示例:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
import java.util.concurrent.CountDownLatch;

// 示例:计数器
public class CountDownLatchDemo {
public static void main(String[] args) throws InterruptedException {
// 初始化计数器,总数为 6
CountDownLatch countDownLatch = new CountDownLatch(6);

// 创建并启动 6 个线程
for (int i = 1; i <= 6; i++) {
new Thread(() -> {
System.out.println(Thread.currentThread().getName() + " Go out");
countDownLatch.countDown(); // 计数器减 1
}, String.valueOf(i)).start();
}

// 等待计数器归零,然后继续执行
countDownLatch.await();
System.out.println("Close Door");
}
}
  • 工作原理:
    • 计数器初始化: 在创建 CountDownLatch 对象时,指定计数器的初始值(如 new CountDownLatch(6))
    • 任务线程执行: 每个线程执行任务后调用 countDown(),使计数器减 1
    • 等待线程阻塞: 调用 await() 的线程进入阻塞状态,等待计数器归零
    • 计数器归零: 当所有任务线程执行完毕(即计数器减为 0),所有等待线程被唤醒,继续执行后续代码

8.2 CyclicBarrier

  • 允许一组线程彼此等待,直到所有线程都到达某个公共屏障点。与 CountDownLatch 不同的是,它是一种可重用的屏障机制

  • 主要特性:

    • 加法计数器: 指定线程数的栅栏点,只有所有线程都达到该点后才会继续执行
    • 可重用: 计数器归零后可以重新使用,不同于 CountDownLatch 的一次性计数器
    • 公共屏障点: 可以在所有线程到达屏障点后执行特定任务
  • 主要方法:

    • await():
      • 使当前线程等待,直到所有线程都调用 await() 并达到屏障点
      • 当所有线程都调用该方法时,将执行可选的 barrierAction
    • getNumberWaiting():
      • 返回当前等待屏障点的线程数
    • isBroken():
      • 返回屏障是否被打破
      • 若某个线程在等待时被中断或超时,屏障被打破,所有等待线程抛出 BrokenBarrierException
  • 应用场景:

    • 并行任务协调: 等待一组线程都到达某个屏障点再继续执行
    • 分阶段执行: 分批次执行多线程任务
  • 源码分析:

    • 构造方法:初始化计数器和可选的屏障动作
    1
    2
    3
    4
    5
    6
    public CyclicBarrier(int parties, Runnable barrierAction) {
    if (parties <= 0) throw new IllegalArgumentException();
    this.parties = parties;
    this.count = parties;
    this.barrierCommand = barrierAction;
    }
    • await() 方法:
      • 调用 dowait() 方法等待
      • 计数器减 1,当减到 0 时,执行屏障动作并重置计数器
    1
    2
    3
    4
    5
    6
    7
    8
    9
    private int dowait(boolean timed, long nanos)
    throws InterruptedException, BrokenBarrierException, TimeoutException {
    // ...
    int index = --count;
    if (index == 0) {
    // ...
    }
    // ...
    }
  • 代码示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
public class CyclicBarrierDemo {
public static void main(String[] args) {
// 创建一个屏障点,指定 7 个线程,并在最后一个线程到达后执行召唤神龙的任务
CyclicBarrier cyclicBarrier = new CyclicBarrier(7, () -> {
System.out.println("召唤神龙成功!");
});

// 创建并启动 7 个线程,模拟收集 7 颗龙珠的过程
for (int i = 1; i <= 7; i++) {
final int temp = i;
new Thread(() -> {
System.out.println(Thread.currentThread().getName() + " 收集第 " + temp + " 颗龙珠");

try {
cyclicBarrier.await(); // 等待其他线程到达屏障点
} catch (InterruptedException | BrokenBarrierException e) {
e.printStackTrace();
}
}).start();
}
}
}
  • 工作原理:
    • 计数器初始化: 创建 CyclicBarrier 时,指定需要互相等待的线程数(parties)
    • 线程等待: 每个线程调用 await() 方法,计数器减 1,并阻塞等待
    • 屏障点到达: 当计数器减到 0 时:
      • 执行可选的 barrierAction。
      • 唤醒所有等待线程。
      • 重置计数器,以便屏障重新使用。
    • 屏障被打破: 当等待的线程被中断或超时:
      • 抛出 BrokenBarrierException。
      • 屏障被打破,所有等待线程不再阻塞。

8.3 Semaphore

  • 一种信号量实现,用于控制对共享资源的访问
    • 信号量维护了一个计数器,计数器的值表示当前可用的资源数
    • 线程可以通过信号量获取或释放资源,从而控制同时访问共享资源的线程数量
  • 主要方法:
    • acquire():
      • 获取一个许可,如果没有可用许可,则阻塞等待
      • 可重载为 acquire(int permits) 来获取多个许可
    • release():
      • 释放一个许可,增加可用许可的数量
      • 可重载为 release(int permits) 来释放多个许可
  • 构造方法:
    • Semaphore(int permits):构造一个具有指定许可数量的信号量
    • Semaphore(int permits, boolean fair):构造一个具有指定许可数量的信号量,并指定公平性
      • fair 为 true 时,实现公平性,按照线程的等待顺序分配许可
  • 应用场景:
    • 限流控制: 控制同时访问的线程数量,类似于限制并发访问的连接池(如:限制 Web 服务的最大并发请求数)
    • 资源互斥: 访问资源时确保互斥性,类似于互斥锁的实现
    • 多线程协作: 控制任务的执行顺序,实现多个线程间的协调
  • 代码示例:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
public class SemaphoreDemo {
public static void main(String[] args) {
// 创建一个具有 3 个许可的信号量
Semaphore semaphore = new Semaphore(3);

// 模拟 6 辆车争抢 3 个停车位
for (int i = 1; i <= 6; i++) {
new Thread(() -> {
try {
// 获取一个停车位
semaphore.acquire();
System.out.println(Thread.currentThread().getName() + " 抢到车位");
TimeUnit.SECONDS.sleep(2);
System.out.println(Thread.currentThread().getName() + " 离开车位");
} catch (InterruptedException e) {
e.printStackTrace();
} finally {
// 释放停车位
semaphore.release();
}
}, "车" + i).start();
}
}
}
  • 工作原理:
    • 信号量初始化:
      • 创建 Semaphore 对象时,指定初始的许可数量(permits)
      • 内部通过 AQS(AbstractQueuedSynchronizer)的状态来维护许可数量
    • 获取资源:acquire()
      • 如果可用资源大于 0,则直接减 1 并返回
      • 否则,当前线程进入等待队列,阻塞等待资源释放
    • 释放资源:release()
      • 增加可用资源数量,唤醒等待队列中的第一个线程

9. 读写锁 ReadWriteLock

9.1 概述

  • ReadWriteLock 是 JUC 中的一种高级锁,实现了读写锁机制

    • ReentrantReadWriteLock 是 ReadWriteLock 接口的实现类,包含内部类 ReadLock 和 WriteLock
    • ReadLock 和 WriteLock 实现了 Lock 接口
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    public class ReentrantReadWriteLock implements ReadWriteLock, java.io.Serializable {
    // ...
    public static class ReadLock implements Lock, java.io.Serializable { // 读锁
    // ...
    }

    public static class WriteLock implements Lock, java.io.Serializable { // 写锁
    // ...
    }
    // ...
    }

9.2 读写锁特点

  • 读锁与写锁的互斥关系:

    • 共享锁(读锁): 多个线程可以同时持有读锁
    • 独占锁(写锁): 只能有一个线程持有写锁
  • 读写锁特点:

    • 读-读共存: 允许多个线程同时读取数据
    • 读-写互斥: 读操作和写操作不能同时进行(保证读操作读取到一致的已提交数据)
    • 写-写互斥: 只允许一个线程执行写操作
  • 读写锁的作用:

    • 提高多线程环境下读操作的并发性,适用于读多写少的场景

    • 提供锁降级机制,实现数据一致性和性能的平衡

  • 与其他锁的对比:

    • synchronized: 独占锁,每次只能一个线程访问
    • ReentrantLock: 独占锁,具备可重入性和公平性
    • ReentrantReadWriteLock: 读写锁,读读共享、读写互斥
  • 应用场景:适用于读多写少的场景,提高读操作并发性

    • 如:缓存系统、配置中心
  • 代码示例:使用读写锁的缓存实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
class MyCacheLock {
private volatile Map<String, Object> map = new HashMap<>();
private ReadWriteLock rwLock = new ReentrantReadWriteLock();

// 写入
public void put(String key, Object value) {
rwLock.writeLock().lock(); // 加写锁
try {
System.out.println(Thread.currentThread().getName() + " 写入 " + value);
map.put(key, value);
System.out.println(Thread.currentThread().getName() + " 写入成功");
} finally {
rwLock.writeLock().unlock(); // 释放写锁
}
}

// 读取
public void get(String key) {
rwLock.readLock().lock(); // 加读锁
try {
System.out.println(Thread.currentThread().getName() + " 读取 " + key);
Object o = map.get(key);
System.out.println(Thread.currentThread().getName() + " 读取成功");
} finally {
rwLock.readLock().unlock(); // 释放读锁
}
}
}

9.3 锁降级

  • 读写锁的锁降级:指将持有的写锁降级为读锁,在持有写锁的情况下获取读锁,然后释放写锁的过程
    • 作用:在一边读一边写的情况下提高性能
      • 确保数据的一致性和可见性
    • 锁降级和不降级的区别:
      • 降级步骤:获取写锁 => 获取读锁 => 释放写锁 => 持有读锁,确保数据一致性
        • 保证数据的可见性,在释放写锁后继续保持读锁,确保在写锁被释放后,其他线程不能立即获取写锁修改数据(写了之后读完了别人才能写)
        • 降低锁的竞争,提高读操作的并发性
      • 不降级步骤:获取写锁 => 释放写锁 => 获取读锁 => 释放读锁
        • 直接释放写锁并获取读锁,可能存在数据被其他写操作修改的风险
        • 在高并发场景中,可能会出现读到不一致的数据,降低数据的一致性
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
class MyCacheWithLockDowngrade {
private volatile Map<String, Object> map = new HashMap<>();
private final ReadWriteLock rwLock = new ReentrantReadWriteLock();

// 写入操作,带锁降级
public void put(String key, Object value) {
rwLock.writeLock().lock(); // 获取写锁
try {
System.out.println(Thread.currentThread().getName() + " 写入 " + value);
map.put(key, value);
System.out.println(Thread.currentThread().getName() + " 写入成功");

rwLock.readLock().lock(); // 锁降级
} finally {
rwLock.writeLock().unlock(); // 释放写锁
}

try {
System.out.println(Thread.currentThread().getName() + " 读取 " + key + " after write");
Object readValue = map.get(key);
System.out.println(Thread.currentThread().getName() + " 读取成功: " + readValue);
} finally {
rwLock.readLock().unlock(); // 释放读锁
}
}

// 读取操作
public void get(String key) {
rwLock.readLock().lock(); // 获取读锁
try {
System.out.println(Thread.currentThread().getName() + " 读取 " + key);
Object o = map.get(key);
System.out.println(Thread.currentThread().getName() + " 读取成功: " + o);
} finally {
rwLock.readLock().unlock(); // 释放读锁
}
}
}

10. 阻塞队列

10.1 基本介绍

  • 阻塞队列是 Java 并发包中的一种数据结构,提供了一种线程安全的队列操作方式,具有阻塞特性,即在队列满或空时,添加或移除元素的操作会被阻塞,直到队列发生变化
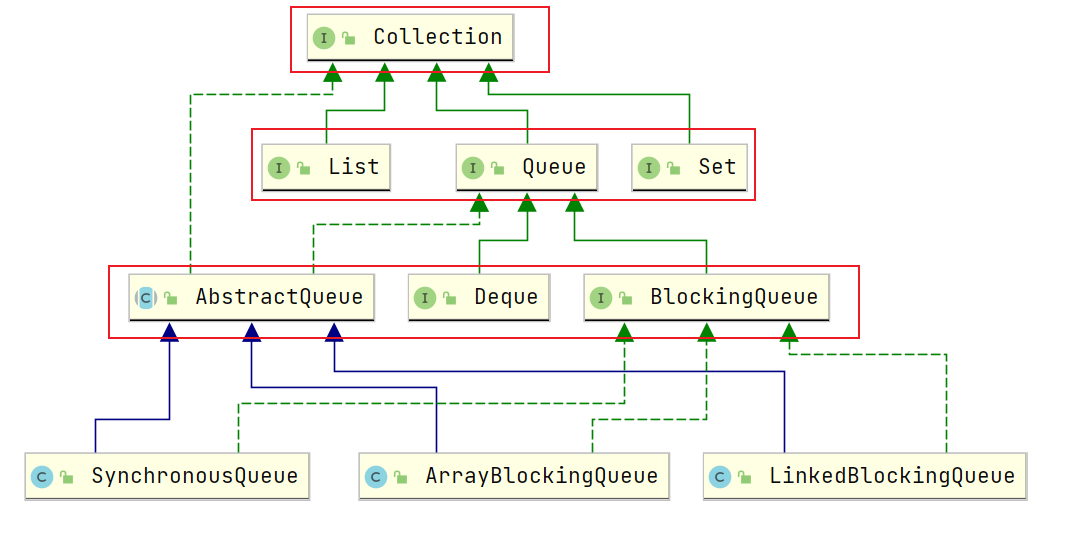
  • 继承关系:
    • BlockingQueue 接口是 Queue 接口的子接口,位于 java.util.concurrent 包中
    • 阻塞队列的实现类有 ArrayBlockingQueue、LinkedBlockingQueue、SynchronousQueue 等

image-20240511145808363

  • 应用场景:
    • 多线程并发处理场景:用于生产者-消费者模式等
    • 线程池:用于任务调度和任务队列管理

10.2 四组 API

  • 阻塞队列提供了四组 API,分别适用于不同的场景,具体如下:
    • 抛出异常: 在操作失败时,抛出异常
    • 不抛出异常,有返回值: 在操作失败时,返回特定值或标识
    • 阻塞等待: 在操作失败时,线程会阻塞等待
    • 超时等待: 在操作失败时,线程会阻塞等待一段时间后返回
方式 抛出异常 有返回值,不抛出异常 阻塞等待 超时等待
添加 add(E e) offer(E e) put() offer(E e, long timeout, TimeUnit unit)
移除 remove() poll() take() poll(long timeout, TimeUnit unit)
获取队首元素 element() peek() - -
  • 代码测试:

    • 抛出异常:add() 方法底层调用的 offer() 方法
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    public static void main(String[] args) {
    BlockingQueue<String> blockingQueue = new ArrayBlockingQueue<>(3);

    // 获取队首元素 队首不存抛异常: NoSuchElementException
    // System.out.println(blockingQueue.element());
    System.out.println(blockingQueue.add("a")); // true
    System.out.println(blockingQueue.add("b")); // true
    System.out.println(blockingQueue.add("c")); // true
    System.out.println(blockingQueue.element()); // a 获取队首元素

    // 抛出异常: IllegalStateException: Queue full
    // System.out.println(blockingQueue.add("d"));

    System.out.println(blockingQueue.remove()); // a
    System.out.println(blockingQueue.remove()); // b
    System.out.println(blockingQueue.remove()); // c

    // 抛出异常: NoSuchElementException
    // System.out.println(blockingQueue.remove());
    }
    • 不抛出异常:而是返回特殊值(通常是 false 或 null)
      • offer() 方法的源码第一句就是判断是否为 null,也就是不能添加 null 值;而 add() 方法底层也是直接调用的 offer() 方法,所以也不可以添加 null 值
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    public static void main(String[] args) {
    BlockingQueue<String> blockingQueue = new ArrayBlockingQueue<>(3);

    // 获取队首元素 队首不存在不抛异常
    System.out.println(blockingQueue.peek()); // null
    System.out.println(blockingQueue.offer("a")); // true
    System.out.println(blockingQueue.offer("b")); // true
    System.out.println(blockingQueue.offer("c")); // true
    // 不抛出异常
    System.out.println(blockingQueue.offer("d")); // false
    System.out.println(blockingQueue.peek()); // a

    System.out.println(blockingQueue.poll()); // a
    System.out.println(blockingQueue.poll()); // b
    System.out.println(blockingQueue.poll()); // c
    // 不抛出异常
    System.out.println(blockingQueue.poll()); // null
    }
    • 阻塞等待:线程在操作不能立即执行时阻塞等待,直到操作可以执行
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    public static void main(String[] args) throws InterruptedException {
    BlockingQueue<String> blockingQueue = new ArrayBlockingQueue<>(3);

    blockingQueue.put("a");
    blockingQueue.put("b");
    blockingQueue.put("c");

    // 此时队列已满, 控制台窗口会一直阻塞等待
    // blockingQueue.put("d");

    System.out.println(blockingQueue.take()); // a
    System.out.println(blockingQueue.take()); // b
    System.out.println(blockingQueue.take()); // c

    // 此时队列已空, 控制台窗口会一直阻塞等待
    // System.out.println(blockingQueue.take());
    }
    • 超时等待:线程在操作不能立即执行时阻塞等待一定的时间,如果在指定的时间内操作不能执行,则返回特殊值
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    public static void main(String[] args) throws InterruptedException {
    BlockingQueue<String> blockingQueue = new ArrayBlockingQueue<>(3);

    blockingQueue.offer("a");
    blockingQueue.offer("b");
    blockingQueue.offer("c");

    // 尝试在2秒内添加元素,如果不能添加则放弃
    boolean status = blockingQueue.offer("d", 2, TimeUnit.SECONDS);
    System.out.println(status); // false

    System.out.println(blockingQueue.poll()); // a
    System.out.println(blockingQueue.poll()); // b
    System.out.println(blockingQueue.poll()); // c

    // 尝试在2秒内取出元素,如果队列空则放弃
    String element = blockingQueue.poll(2, TimeUnit.SECONDS);
    System.out.println(element); // null
    }

10.3 SynchronousQueue 同步队列

  • SynchronousQueue 是阻塞队列的特殊实现(一种无缓冲的等待队列),没有容量,也可以视为容量为1的队列

    • 相对于有缓冲的 BlockingQueue 来说,少了一个中间经销商的环节(缓冲区)
  • 特点:添加一个元素必须等待另一个线程取走,否则一直阻塞

  • 方法:

    • put(E e):将元素放入队列中。如果没有其他线程正在尝试取走元素,此方法会阻塞
    • take():取走队列中的元素。如果没有元素可取,此方法会阻塞,使用Lock 锁保证线程安全
  • 公平性选择:构造 SynchronousQueue 时可以选择公平性。如果设置为公平模式,则线程按照等待时间的长短获得访问权;非公平模式则随机分配

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
// 如果输出不一致可能是因为 System.out.println 导致的竞态条件或线程调度问题
public class SynchronousQueueDemo {
public static void main(String[] args) {
BlockingQueue<String> synchronousQueue = new SynchronousQueue<>();

new Thread(() -> {
try {
System.out.println(Thread.currentThread().getName() + " Put 1");
synchronousQueue.put("1");
System.out.println(Thread.currentThread().getName() + " Put 2");
synchronousQueue.put("2");
System.out.println(Thread.currentThread().getName() + " Put 3");
synchronousQueue.put("3");
} catch (InterruptedException e) {
e.printStackTrace();
}
}, "T1").start();

new Thread(() -> {
try {
System.out.println(Thread.currentThread().getName() + " Take " + synchronousQueue.take());
} catch (InterruptedException e) {
e.printStackTrace();
}
}, "T2").start();
}
}

11. 线程池(重点)

11.1 概述

  • 线程池是一种基于池化技术的资源管理工具,用于有效管理线程资源

  • 线程池的好处:线程可以复用,可以控制最大并发量,管理线程

    • 降低资源消耗:通过重复利用已创建的线程降低线程创建和销毁的开销
    • 提高响应速度:减少了线程创建的时间,改善了程序的响应速度
    • 方便线程管理:线程池可以统一分配、调优和监控线程
  • Java线程池关键组件

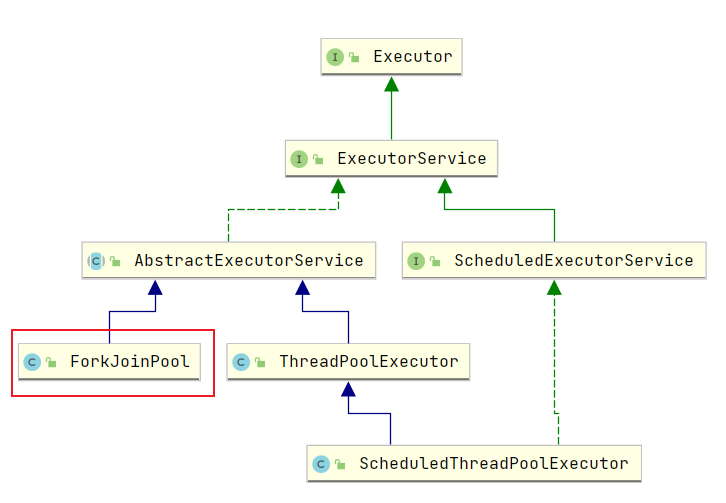
    • Executor 框架:Java 提供的线程池实现框架,包括以下几个关键类:
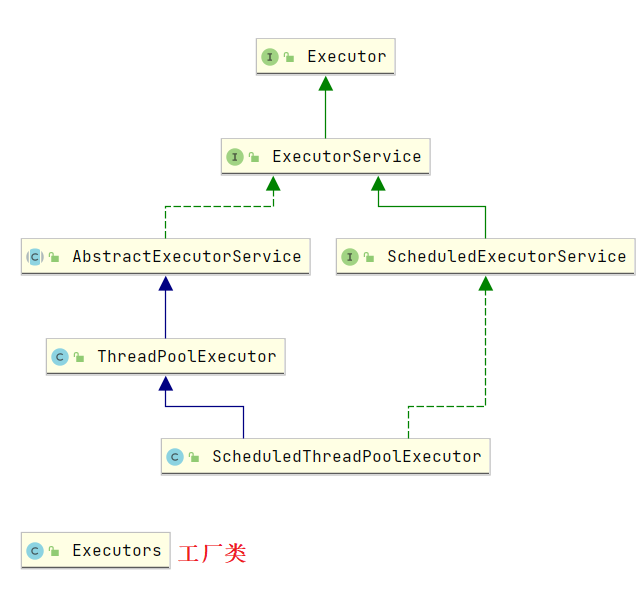
      • Executor:负责线程使用和调度的根接口。
      • Executors:工厂类,用于创建不同类型的线程池。
      • ExecutorService:继承自Executor接口,定义了线程池的生命周期管理方法,如启动、关闭、提交任务等。
      • AbstractExecutorService:ExecutorService 接口的抽象实现类,提供了 ExecutorService 的基本实现。
      • ThreadPoolExecutor:AbstractExecutorService 的具体实现类,提供了创建线程池的完整功能。

image-20240511171447844

  • 线程池:三大方法,7大参数,4种拒绝策略

11.2 三大方法

  • 线程池的三种常用创建方式(通过Executors)

    • SingleThreadExecutor:单个后台线程的线程池
    1
    ExecutorService singleThreadExecutor = Executors.newSingleThreadExecutor();
    • FixedThreadPool:固定大小的线程池
    1
    ExecutorService fixedThreadPool = Executors.newFixedThreadPool(5);
    • CachedThreadPool:大小不固定的线程池,根据需求自动更改数量
    1
    ExecutorService cachedThreadPool = Executors.newCachedThreadPool();
  • 代码示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
// Executors 三大方法
public class Demo01 {
public static void main(String[] args) {

ExecutorService threadPool = Executors.newSingleThreadExecutor();//单个线程
ExecutorService threadPool2 = Executors.newFixedThreadPool(5); //创建一个固定的线程池的大小
ExecutorService threadPool3 = Executors.newCachedThreadPool(); //可伸缩的

// 线程池用完必须要关闭线程池
try {

for (int i = 1; i <=100 ; i++) {
//通过线程池创建线程
threadPool.execute(()->{
System.out.println(Thread.currentThread().getName()+ " ok");
});
}
} catch (Exception e) {
e.printStackTrace();
} finally {
threadPool.shutdown();
}
}
}
  • 注意:阿里开发规范文档指出 => 线程池不允许使用 Executors 去创建,而是通过 ThreadPoolExecutor 的方式,这样的处理方式让编写人员更加明确线程池的运行规则,同时规避资源耗尽的风险,Executors 各个方法的弊端:
    • FixedThreadPool 和 SingleThreadExecutor:允许的请求队列长度为 Integer.MAX_VALUE,可能会堆积大量的请求,从而导致 OOM
    • CachedThreadPool 和 ScheduledThreadPool:允许创建的线程数量为 Integer.MAX_VALUE(约为21亿),可能会创建大量的线程,从而导致 OOM

11.3 七大参数-自定义线程池

  • Executors 创建方式底层源码分析:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
public static ExecutorService newSingleThreadExecutor() {
// 核心线程数和最大线程数都为1,即只有一个线程
return new FinalizableDelegatedExecutorService
(new ThreadPoolExecutor(1, 1,
0L, TimeUnit.MILLISECONDS,
new LinkedBlockingQueue<Runnable>()));
}

public static ExecutorService newFixedThreadPool(int nThreads) {
// 创建 ThreadPoolExecutor 实例,核心线程数和最大线程数都为指定的线程数
return new ThreadPoolExecutor(nThreads, nThreads,
0L, TimeUnit.MILLISECONDS,
new LinkedBlockingQueue<Runnable>());
}

public static ExecutorService newCachedThreadPool() {
// 创建 ThreadPoolExecutor 实例,核心线程数为0,最大线程数为 Integer.MAX_VALUE,表示大小不固定
return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
60L, TimeUnit.SECONDS,
new SynchronousQueue<Runnable>());
}
  • 本质:三种方法都是调用的 ThreadPoolExecutor
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
public class ThreadPoolExecutorAnalysis {

public ThreadPoolExecutor(int corePoolSize, // 核心线程池大小
int maximumPoolSize, // 最大的线程池大小
long keepAliveTime, // 超时了没有人调用就会释放
TimeUnit unit, // 超时单位
BlockingQueue<Runnable> workQueue, // 阻塞队列
ThreadFactory threadFactory, // 线程工厂 创建线程的 一般不用动
RejectedExecutionHandler handler // 拒绝策略
) {
if (corePoolSize < 0 || maximumPoolSize <= 0 || maximumPoolSize < corePoolSize || keepAliveTime < 0)
throw new IllegalArgumentException();
if (workQueue == null || threadFactory == null || handler == null)
throw new NullPointerException();

// 将传入的参数赋值给对应的属性
this.corePoolSize = corePoolSize; // 设置核心线程池大小
this.maximumPoolSize = maximumPoolSize; // 设置最大的线程池大小
this.workQueue = workQueue; // 设置阻塞队列
this.keepAliveTime = unit.toNanos(keepAliveTime); // 设置超时时间
this.threadFactory = threadFactory; // 设置线程工厂
this.handler = handler; // 设置拒绝策略
}
}
  • 推荐使用底层线程池手动创建方式:使用 ThreadPoolExecutor 直接构造,这种方式允许自定义参数,更灵活,可以明确线程池的运行规则,避免资源耗尽的风险,七大参数:
    • corePoolSize:核心线程数,即不被回收的线程数量,除非设置了allowCoreThreadTimeOut。
    • maximumPoolSize:最大线程数,能容纳的最大线程数量。
    • keepAliveTime:线程空闲后的存活时长。
    • unit:时间单位,与 keepAliveTime 配合使用。
    • workQueue:任务队列,被提交但未执行的任务。
    • threadFactory:线程工厂,用于创建线程。
    • handler:拒绝策略,当任务太多来不及处理时,如何拒绝任务。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
public class CustomThreadPoolExample {

public static void main(String[] args) {
// 自定义线程池,设置核心线程数为2,最大线程数为5,线程空闲时间为3秒,
// 使用有界队列 LinkedBlockingQueue 容量为3,使用默认线程工厂,使用丢弃最旧任务的拒绝策略
ThreadPoolExecutor threadPoolExecutor = new ThreadPoolExecutor(
2, // 核心线程池大小
5, // 最大线程池大小
3, // 超时时间
TimeUnit.SECONDS, // 超时单位
new LinkedBlockingQueue<>(3), // 使用有界队列 LinkedBlockingQueue,容量为3
Executors.defaultThreadFactory(), // 默认线程工厂
new ThreadPoolExecutor.DiscardOldestPolicy() // 丢弃最旧任务的拒绝策略
);

// 最大承载:队列容量 + 最大线程数
// 提交8个任务给自定义线程池执行
for (int i = 0; i < 8; i++) {
// 使用线程池来执行任务
threadPoolExecutor.execute(() -> {
System.out.println(Thread.currentThread().getName() + " ok");
});
}

// 关闭线程池
try {
threadPoolExecutor.shutdown();
} catch (Exception e) {
e.printStackTrace();
}
}
}
  • 底层工作原理:

    • 假设来了9个线程,在执行execute()方法才创建线程
    • 第1-2个线程进入线程池创建
    • 第3-5个线程进入阻塞队列
    • 第6-8个线程会为他们创建新线程执行(直接运行线程6而非线程3)
    • 第9个线程会被拒绝

    总结:先到常驻线程,满了之后再到阻塞队列进行等待,阻塞队列满了之后,在往外扩容线程,扩容线程不能大于最大线程数。大于最大线程数和阻塞队列之和后,会执行拒绝策略

image-20240511192424588

11.4 四种策略

  • new ThreadPoolExecutor.AbortPolicy():默认策略,抛出异常阻止系统正常运行
  • new ThreadPoolExecutor.CallerRunsPolicy():调用者运行,将任务回退到调用者,降低新任务流量
  • new ThreadPoolExecutor.DiscardPolicy():丢弃任务,不抛出异常
  • new ThreadPoolExecutor.DiscardOldestPolicy():抛弃队列中等待最久的任务,尝试再次提交当前任务

11.5 如何设置线程池的最大大小

在设置线程池的最大大小时,针对CPU密集型和IO密集型任务有不同考虑

对于不同类型的任务,应该根据任务的特点和系统资源情况来灵活设置线程池的最大大小,以提高系统的效率和性能

  • CPU密集型任务:
    • 设置线程池的最大大小为处理器核心数,这样可以最大程度地利用CPU资源,避免线程过多导致线程切换频繁而降低效率
    • 可以通过代码获取处理器核心数,然后将最大线程数设置为相应的核心数
1
int coreCount = Runtime.getRuntime().availableProcessors();
  • IO密集型任务:
    • 根据程序中IO操作的情况来确定最大线程池大小
    • 通常情况下,可以将最大线程数设置为大约是最大I/O数的一倍到两倍之间,以保证足够的线程处理IO任务

12. 四大函数式接口(必须掌握!)

Java 程序员必须掌握:

泛型、枚举、反射

lambda表达式、链式编程、函数式接口、Stream流式计算

12.1 概述

  • 函数式接口:仅定义一个抽象方法的接口
  • 函数式接口通常标注了@FunctionalInterface注解,这不是必需的,但有助于编译器检查接口是否符合函数式接口的定义
1
2
3
4
@FunctionalInterface
public interface Runnable {
public abstract void run();
}
  • Java 8引入的四大函数式接口分别是Consumer、Function、Predicate、和Supplier,这些接口主要用于常见的操作:消费、转换、断言和提供

  • 应用场景:

    • Function:适用于转换数据,如从一种类型映射到另一种类型
    • Predicate:常用于筛选数据,如在集合操作中进行条件过滤
    • Consumer:常用于处理从数据源消费数据,如打印、存储操作
    • Supplier:适用于需要多次返回结果的场景,如工厂方法、构造器引用等
  • 在特定的应用场景下,还可以定义自己的函数式接口来更好地满足需求

1
2
3
4
@FunctionalInterface
public interface CheckedFunction<T, R> {
R apply(T t) throws Exception;
}

12.2 Function 接口

  • 函数型接口:接受一个输入参数,返回一个结果
  • 源码:
1
2
3
4
5
@FunctionalInterface
public interface Function<T, R> {
R apply(T t);
// ...
}
  • 代码测试:
1
2
3
4
5
6
7
8
9
/**
* Function函数型接口
*/
public class Demo01 {
public static void main(String[] args) {
Function<String,String> function = (str) ->{return str;};
System.out.println(function.apply("starasdas"));
}
}

12.3 Predicate 接口

  • 断定型接口:接受一个输入参数,返回一个布尔值
  • 源码:
1
2
3
4
5
@FunctionalInterface
public interface Predicate<T> {
boolean test(T t);
// ...
}
  • 代码测试:
1
2
3
4
5
6
7
8
9
10
11
/**
* 断定型接口:有一个输入参数,返回值只能是 布尔值!
*/
public class Demo2 {
public static void main(String[] args) {
//判断字符串是否为空
Predicate<String> predicate = (str)->{return str.isEmpty();};
System.out.println(predicate.test("11"));
System.out.println(predicate.test(""));
}
}

12.4 Consumer 接口

  • 消费型接口:接受单一输入参数,不返回结果
  • 源码:
1
2
3
4
5
@FunctionalInterface
public interface Consumer<T> {
void accept(T t);
// ...
}
  • 代码测试:
1
2
3
4
5
6
7
8
9
10
11
/**
* 消费型接口 没有返回值!只有输入!
*/
public class Demo3 {
public static void main(String[] args) {
Consumer<String> consumer = (str)->{
System.out.println(str);
};
consumer.accept("abc");
}
}

12.5 Supplier 接口

  • 供给型接口:无参数,返回一个结果
  • 源码:
1
2
3
4
@FunctionalInterface
public interface Supplier<T> {
T get();
}
  • 代码测试:
1
2
3
4
5
6
7
8
9
/**
* 供给型接口,只返回,不输入
*/
public class Demo4 {
public static void main(String[] args) {
Supplier<String> supplier = ()->{return "1024";};
System.out.println(supplier.get());
}
}

13. Stream 流式计算

  • Stream 流式计算是Java 8中引入的一项强大的新特性,它允许以声明性方式处理数据集合

    • 通过 Stream API 对数据进行高效的查询、过滤、转换、聚合等操作,无需编写冗长的代码
    • 对集合对象功能的增强,专注于对集合对象进行各种便捷和高效的聚合操作或大批量数据操作,借鉴了函数式编程语言的许多概念,利用更丰富的语法对集合数据进行查询和处理
  • 特点:

    • 不是数据结构:Stream不存储数据,它只是在源数据(如集合、数组)的基础上提供了一种对数据的高效处理方式
    • 只能遍历一次:和迭代器类似,流一旦遍历过一次,便不能重复使用或“倒带”
    • 延迟执行:很多Stream操作都是延迟执行的,只有在需要结果的时候才执行(只有在终端操作执行时,所有中间操作才会被实际执行)
      • 可以避免对数据的不必要处理,特别是在链式调用中,可以合并多个操作,减少遍历次数
    • 支持并行处理:Stream有串行和并行两种模式,通过并行模式可以利用多核处理器的优势,提高执行效率
    1
    2
    3
    4
    5
    6
    7
    List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5, 6, 7, 8, 9, 10);
    // 并行处理一组数字,筛选出偶数并计算它们的和
    int sum = numbers.parallelStream()
    .filter(n -> n % 2 == 0)
    .mapToInt(Integer::intValue)
    .sum();
    System.out.println("Sum of even numbers: " + sum);
  • 核心操作:Stream 操作可以分为中间操作和终端操作两种:

    • 中间操作:中间操作都会返回一个新的 Stream。常见的中间操作有filter(过滤)、map(映射)、sorted(排序)等
    • 终端操作:终端操作会从 Stream 产生结果,之后不能再使用Stream。常见的终端操作包括forEach( 遍历流中的每个元素,执行给定的操作)、collect(将Stream转换成不同类型的结果)、reduce(通过某个连接操作将所有元素汇聚成一个汇总结果)、findAny(返回流中的任意元素)等
  • 代码示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
public class Test {
public static void main(String[] args) {
User user1 = new User(1, "a", 21);
User user2 = new User(2, "b", 22);
User user3 = new User(3, "c", 23);
User user4 = new User(4, "d", 24);
User user5 = new User(5, "e", 25);
User user6 = new User(6, "f", 26);
List<User> list = Arrays.asList(user1, user2, user3, user4, user5, user6);

// 计算交给流,使用链式编程
list.stream()
.filter(u -> u.getId() % 2 == 0) // 筛选出ID为偶数的用户
.filter(u -> u.getAge() > 23) // 进一步筛选出年龄大于23的用户
.map(u -> u.getName().toUpperCase()) // 将用户的名字转换为大写
.sorted((uu1, uu2) -> uu2.compareTo(uu1)) // 按名字降序排序, 也可直接 Comparator.reverseOrder()
.limit(1) // 限制结果数量为1
.forEach(System.out::println); // 打印最终结果 F

// list.stream()
// .filter(u -> u.getId() % 2 == 0) // 筛选出ID为偶数的用户
// .filter(u -> u.getAge() > 23) // 进一步筛选出年龄大于23的用户
// .map(u->{u.setName(u.getName().toUpperCase()); return u;}) // 将用户的名字转换为大写
// .sorted((uu1, uu2) -> uu2.getName().compareTo(uu1.getName())) // 按名字降序排序, 也可直接 Comparator.reverseOrder()
// .limit(1) // 限制结果数量为1
// .forEach(System.out::println); // 打印最终结果 User{id=6, name='F', age=26}
}
}
  • 应用场景:

    • 数据筛选和转换:如从数据库查询到的记录进行预处理,例如过滤、转换等

    • 聚合统计:如统计某个字段的平均值、最大值、最小值等

    • 并行运算:利用Stream的并行流大幅提高数据处理速度

14. Fork/Join 分支合并

14.1 概述

  • Fork/Join 框架是自 Java 7 引入的一个用于并行执行任务的工具,尤其适合处理那些可以递归方式拆分成更小任务的大问题

    • 基于“分治法”的设计思想,旨在充分利用多核处理器的计算能力来提高应用性能
  • 特点:工作窃取(Work Stealing)

    • Fork/Join 框架采用工作窃取算法来平衡工作负载。每个线程都维护一个双端队列,忙碌的线程可以将部分任务(从队列尾部拿取)转移给空闲的线程(从队列头部拿取)
  • 实现原理:双端队列

    • 每个工作线程都有自己的双端队列,用来存放分配给自己的任务
    • 线程主要从自己的队列中取任务执行,当自己的队列空时,可以从其他线程的队列尾部“窃取”任务
  • 核心:Fork/Join 框架的核心在于两个操作:fork() 和 join()

    • Fork:将大任务拆分成若干子任务,子任务可以并行执行
    • Join:等待子任务完成,并将所有子任务的结果合并成总结果
  • 使用场景:

    • 大数据处理
    • 图像处理
    • 大规模数值处理
  • 使用方法:

    • 创建 ForkJoinPool:所有 ForkJoin 任务都需要通过 ForkJoinPool 来执行,ForkJoinPool 是任务管理和执行的核心
    • 定义任务:创建继承自ForkJoinTask(通常是它的子类 RecursiveAction 或 RecursiveTask)的类
      • RecursiveTask(有返回值)
      • RecursiveAction(无返回值)
    • 启动任务:通过 ForkJoinPool 的 invoke() 或 submit() 方法启动任务

image-20240512150955213

image-20240512151114324

14.2 代码示例

  • ForkJoinDemo 类:继承自 RecursiveTask<Long>,是一个可以返回结果的任务

    • **临界值 (temp)**:用于控制任务分解的粒度。如果任务的大小小于此值,则不再继续分解任务,而是直接进行计算。

    • **fork()**:将子任务推送到ForkJoinPool的工作队列。

    • **join()**:等待子任务完成,并获取其结果。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
public class ForkJoinDemo extends RecursiveTask<Long> {
private long star; // 任务的起始点
private long end; // 任务的结束点

//临界值,当任务的规模小于这个值时直接进行计算而不再继续分解
private long temp = 1000000L;

public ForkJoinDemo(long star, long end) {
this.star = star;
this.end = end;
}

@Override
protected Long compute() {
if ((end - star) <= temp) {
long sum = 0L;
for (long i = star; i <= end; i++) {
sum += i;
}
return sum;
} else {
// 当任务大于临界值时,继续分解任务
long middle = (star + end) / 2;
ForkJoinDemo task1 = new ForkJoinDemo(star, middle);
task1.fork(); // 将任务推送到ForkJoinPool的工作队列
ForkJoinDemo task2 = new ForkJoinDemo(middle + 1, end);
task2.fork();
// 等待任务执行结束并合并结果
return task1.join() + task2.join();
}
}
}
  • 测试类:使用三种不同的方法来计算从 1 到 20亿的整数和
    • **test1()**:使用单线程迭代的方法计算总和
    • **test2()**:使用 ForkJoin 框架执行同样的计算。通过 ForkJoinPool.invoke() 方法启动 ForkJoin 任务
    • **test3()**:使用 Java 8 Stream API 的并行流进行计算。Stream API 的并行流内部使用的也是 ForkJoinPool
      • .parallel().reduce(0, Long::sum) 使用并行流来执行归约操作,这里用于计算一个长整型数列的总和
      • **.parallel()**:用于将流转换为并行流,并行流利用Java的Fork/Join框架,允许在多核处理器上并行处理任务,从而加快执行速度
      • **.reduce(0, Long::sum)**:通过指定的函数来合并流中的元素,这里使用的是两参数版本的 reduce 方法
        • 第一个参数 0 是流为空时的默认结果
        • 第二个参数 Long::sum 是一个方法引用,指向一个接受两个参数并返回它们的和的方法。它定义了如何合并流中的元素
      • reduce 方法的优点:灵活、不需要存储中间状态,并行性能高、不会修改原始数据源
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
public class Test {
public static void main(String[] args) {
test1(); // 普通迭代方法 sum=2000000001000000000 时间:539
//test2(); // 使用 ForkJoin sum=2000000001000000000 时间:184
//test3(); // 使用 Stream 并行流 sum=2000000001000000000 时间:160
}

public static void test1() {
long start = System.currentTimeMillis();
long sum = 0L;
for (long i = 1; i <= 20_0000_0000L; i++) {
sum += i;
}
long end = System.currentTimeMillis();
System.out.println("sum=" + sum + " 时间:" + (end - start));
}

public static void test2() {
long start = System.currentTimeMillis();
ForkJoinPool pool = new ForkJoinPool();
ForkJoinTask<Long> task = new ForkJoinDemo(0L, 20_0000_0000L);
Long result = pool.invoke(task);
long end = System.currentTimeMillis();
System.out.println("sum=" + result + " 时间:" + (end - start));
}

public static void test3() {
long start = System.currentTimeMillis();
long sum = LongStream.rangeClosed(0L, 20_0000_0000L).parallel().reduce(0, Long::sum);
long end = System.currentTimeMillis();
System.out.println("sum=" + sum + " 时间:" + (end - start));
}
}
  • Stream 并行流提供了最好的性能和最简洁的代码。
  • Fork/Join 框架提供了较好的性能提升,适用于更复杂的任务分解和自定义并行处理逻辑。
  • 普通迭代方法虽然实现最简单,但在处理大数据量时性能最低。

对于大多数大规模计算任务,推荐使用 Stream 并行流或 Fork/Join 框架来利用现代多核 CPU 的计算能力

15. 异步回调

15.1 同步和异步

  • 同步操作:程序按顺序执行,必须等待当前操作完全完成后才能继续到下一步
    • 例如,从数据库读取数据或从网络加载资源,线程会被阻塞,直到操作完成
  • 异步操作:程序可以在等待操作完成的同时继续执行其他任务。
    • 异步操作常见于不希望阻塞主线程的场景,例如GUI应用程序、大规模计算和高性能Web服务器

15.2 CompletableFuture

  • CompletableFuture 是在Java 8中引入的,用于增强现有的Future接口,主要用于异步编程
    • 异步通常意味着非阻塞,可以使得我们的任务单独运行在与主线程分离的其他线程中,并且可以通过回调在主线程中获取异步任务的执行状态、完成情况以及异常信息等
    • CompletableFuture 实现了 Future,CompletionStage 接口,使得它既兼容现有的线程池框架,又提供了异步编程的接口抽象
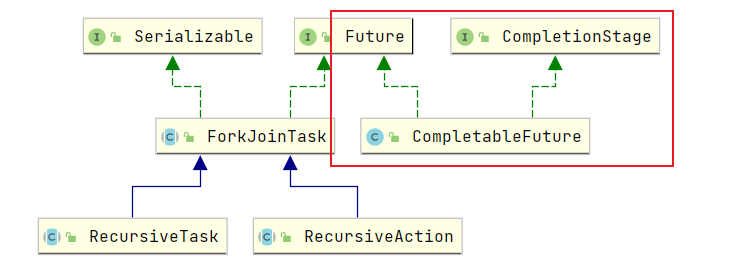
image-20240512185425536

  • 常用方法:
    • runAsync:执行没有返回值的异步任务
    • supplyAsync:执行有返回值的异步任务
  • 特点:
    • 支持手动完成,可以显式地设置其结果
    • 提供了异常处理机制
    • 支持回调函数,当Future完成时可以自动触发
    • 支持链式调用,允许将多个异步操作的结果串联起来
    • 支持合并多个CompletableFuture,可以等待多个CompletableFuture完成后再继续执行
  • 代码示例:
    • whenComplete:此方法接收两个参数:t 和 u
      • t:代表正常返回的结果
      • u:代表抛出异常的错误信息
    • 异常处理:
      • exceptionally:当异步操作发生异常时,可以通过该方法来定义一个回调函数,用于处理异常,该方法接收一个函数,该函数的输入是引发问题的异常对象,并返回一个替代值来“修复”异常情况,继续后续的处理流程
      • get 方法在调用时会阻塞直到异步操作完成。如果操作成功完成,则返回正常的结果;如果操作中发生异常且没有被 exceptionally 方法处理,则会抛出一个 ExecutionException。如果使用 exceptionally 处理了异常,则 get 将返回 exceptionally 中定义的替代值
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
public static void main(String[] args) throws ExecutionException, InterruptedException {
// 没有返回值的异步回调
CompletableFuture<Void> voidCompletableFuture = CompletableFuture.runAsync(() -> {
try {
// 模拟耗时操作
TimeUnit.SECONDS.sleep(2);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println(Thread.currentThread().getName() + " run"); // ForkJoinPool.commonPool-worker-9 run
});
System.out.println("发起了异步请求");
// 阻塞等待任务完成
voidCompletableFuture.get();

// 有返回值的异步回调
// 模拟异步操作,例如ajax请求,成功和失败回调
CompletableFuture<Integer> completableFuture = CompletableFuture.supplyAsync(() -> {
// completableFuture ForkJoinPool.commonPool-worker-9
System.out.println("completableFuture " + Thread.currentThread().getName());
// 模拟异常情况
// int i = 10 / 0;
return 1024;
});

// 使用whenComplete处理正常返回结果和异常
System.out.println(completableFuture.whenComplete((t, u) -> { // 1024 / 233
if (u == null) {
// 正常的返回结果
System.out.println("正常结果:" + t); // 正常结果:1024
} else {
// 异常信息:java.util.concurrent.CompletionException: java.lang.ArithmeticException: / by zero
System.out.println("异常信息:" + u);
}
}).exceptionally((e) -> {
// 异常处理
System.out.println("发生异常:" + e.getMessage()); // 发生异常:java.lang.ArithmeticException: / by zero
return 233;
}).get()); // 阻塞等待任务完成,并获取最终结果
}

15.3 Future VS. CompletableFuture

  • Futrue 在 Java 里面,通常用来表示一个异步任务的引用,比如我们将任务提交到线程池里面,然后我们会得到一个 Futrue,在 Future 里面有 isDone 方法来 判断任务是否处理结束,还有 get 方法可以一直阻塞直到任务结束然后获取结果

    • 但整体来说这种方式,还是同步的,因为需要客户端不断阻塞等待或者不断轮询才能知道任务是否完成
  • 对比Future和CompletableFuture,CompletableFuture优势:

    • 支持非阻塞回调:CompletableFuture支持在任务完成时,自动执行某些函数(回调),而Future则需要调用者不断检查

    • 更丰富的操作:CompletableFuture支持更丰富的方法和流式操作,如thenApply, thenAccept, thenCompose, 和combine等,这些都是Future所不具备的

    • 异常处理:CompletableFuture提供了异常处理的直接支持,而Future则没有

16. JMM

  • JMM(Java Memory Model):JAVA 内存模型,是一个抽象的概念或约定,用于定义Java程序中变量的访问规则以及在多线程环境下如何进行线程间的通信

    • 它描述了程序中各种变量(包括类实例字段、静态字段和构造数组对象)的访问方式
  • JMM 的同步约定:

    • 线程解锁前必须立即将共享变量刷新回主存:确保释放锁时,对变量的修改能够被接下来获取该锁的其他线程看到
    • 线程加锁前必须读取主存中的最新值到工作内存中:确保获取锁后,工作内存中的变量是最新的
    • 加锁和解锁必须是同一把锁:保证锁的获取和释放的一致性
  • 线程内存交互操作:Java 内存模型定义了以下8种操作来控制线程对内存的交互

    • **Read(读取)**:从主内存中读取变量到线程的工作内存
    • **Load(载入)**:在工作内存中对变量赋值(跟随Read操作)
    • **Use(使用)**:使用工作内存中的变量
    • **Assign(赋值)**:向工作内存中的变量赋新值
    • **Store(存储)**:将工作内存中的变量的值写回主内存(准备写入操作)
    • **Write(写入)**:将Store的值真正写入主内存
    • **Lock(锁定)**:标记变量在主内存中开始处于锁定状态
    • **Unlock(解锁)**:标记变量在主内存中结束锁定状态
  • JMM 的操作规定:

    • Read和Load、Store和Write操作必须成对出现:保证内存值的正确传递
    • 线程对变量的修改必须同步回主内存:保证其他线程能看到最新值
    • 初始化变量必须在主内存中进行:避免使用未初始化的数据
    • 变量锁定和解锁必须一致:确保每次只有一个线程可以修改变量
  • 代码示例问题分析:num 变量的更新可能对另一个线程不可见,因为没有适当的同步措施。这可能导致程序无法如预期终止,因为线程1可能永远看不到 num 的更新

1
2
3
4
5
6
7
8
9
10
11
12
private static int num = 0;
public static void main(String[] args) throws InterruptedException {
new Thread(()->{ // 线程1
while (num == 0) {
// 这里可能永远看不到num变化
}
}).start();
TimeUnit.SECONDS.sleep(1);
num = 1; // 主线程更新num
System.out.println(num);
// 线程1可能不知道num已更新
}

为解决这一问题,可以通过添加volatile关键字来声明num变量,这将保证每次读写都直接从主内存完成,从而保证了可见性

17. Volatile

17.1 概述

  • Volatile 是 Java 虚拟机提供的一种轻量级的同步机制
  • 特点:
    • 保证可见性:确保一个线程修改了该变量的值后,其他线程能够立即得知这个修改
    • 不保证原子性:虽然 volatile 变量的读写是原子的,但复合操作(如递增)不是原子的
    • 禁止指令重排:确保编译器在编译过程中不会对涉及 volatile变量的指令进行重排序,这是通过插入内存屏障来实现的

17.2 保证可见性

  • 代码示例:使用 volatile 防止死循环
    • 不使用volatile修饰number,其他线程可能无法看到number的改变,导致无限循环
    • 使用volatile后,一旦number的值被修改,所有线程都能立即看到这一变化
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
public class JMMDemo01 {
// 如果不加 volatile 程序会死循环
// 加了 volatile 是可以保证可见性的
private volatile static Integer number = 0;

public static void main(String[] args) {
new Thread(() -> {
while (number == 0) {
// 循环等待number变化
}
}).start();

try {
TimeUnit.SECONDS.sleep(2);
} catch (InterruptedException e) {
e.printStackTrace();
}

number = 1;
System.out.println(number); // 1
}
}

17.3 不保证原子性

  • 原子性:不可分割,线程在执行任务的时候要么同时成功,要么同时失败
  • 代码示例:验证 volatile 不保证原子性
    • 代码中即使number是volatile变量,number++操作的非原子性导致最终结果可能不是预期的20000
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
/**
* 不保证原子性
* number <= 2w
*/
public class VDemo02 {

private static volatile int number = 0;

public static void add() {
number++; // ++ 不是原子性操作
}

public static void main(String[] args) {
// 理论上number === 20000
for (int i = 1; i <= 20; i++) {
new Thread(() -> {
for (int j = 1; j <= 1000; j++) {
add();
}
}).start();
}

while (Thread.activeCount() > 2) { // main gc
// 只要除了主线程和可能的垃圾收集线程之外还有其他线程在运行, 循环就会继续
// 确保主线程(或任何等待所有其他线程完成的线程)最后执行
Thread.yield();
}
System.out.println(Thread.currentThread().getName() + ",num=" + number);
}
}
  • 如何保证原子性?除了使用lock和synchronized关键字?
    • Java 还提供了基于java.util.concurrent.atomic 包中的一系列原子类
    • 这些原子类使用了高效的机制来保证单个变量操作的原子性,通常是通过底层的CAS(Compare-And-Swap)操作实现
1
2
3
4
5
6
7
// 适用 AtomicInteger 类代替普通的 int 变量
// 确保在多线程环境中对数值的原子性增加操作
private static volatile AtomicInteger number = new AtomicInteger();

public static void add(){
number.incrementAndGet(); // 底层是CAS保证的原子性
}
  • 底层原理:
    • 原子类的工作原理:原子类在底层使用了CAS操作
      • CAS操作涉及三个操作数:内存位置(在这里是number的值)、预期原值和新值
      • 如果内存位置的当前值与预期原值相匹配,那么处理器会自动将该位置值更新为新值。这个过程是原子的,即不可中断,保证了更新操作的原子性
    • Unsafe类:原子类的实现依赖于Unsafe类,这是 Java 中一个提供底层、不安全操作的类,如直接内存访问和非常规的对象实例化等。Unsafe类使得Java能够执行类似指针的操作,并且能够进行底层的内存操作

使用AtomicInteger类和其他原子类是在不想使用显式同步(例如synchronized或Java锁API)时确保数据完整性的一种有效方式。它们特别适用于计数器或累加器,以及任何只需要对单个变量进行原子操作的场景。这些原子类不仅效率高,而且代码简洁,易于理解和维护

17.4 防止指令重排

  • 指令重排:指计算机程序执行过程中,为了优化性能和利用硬件的并行处理能力,编译器和处理器可能会改变指令的执行顺序。重排可以发生在多个阶段:
    • 编译器优化重排:编译器在生成机器代码时,可能会重新安排指令顺序以提高执行效率
    • 指令并行重排:现代处理器可能会并行执行多个指令,无需严格按照程序中的原始顺序
    • 内存系统重排:处理器和内存系统可能会改变操作执行的顺序,这与缓存和内存访问的优化有关
1
源代码–>编译器优化重排–>指令并行也可能会重排–>内存系统也会重排–>执行
  • 数据依赖性:处理器在进行重排时会考虑到指令之间的数据依赖性。如果一条指令的结果依赖于前一条指令的结果,处理器会保留这种依赖关系,确保程序的执行结果符合逻辑的预期

    • 如:理论上,执行顺序可能变为 2-1-3-4 或 1-3-2-4,但不会是 4-1-2-3,因为 4 操作依赖于 3 操作的结果
    1
    2
    3
    4
    int x = 1;  // 1
    int y = 2; // 2
    x = x + 5; // 3
    y = x * x; // 4
  • volatile 防止指令重排:使用 volatile 变量时,JVM 会插入内存屏障来防止指令重排

    • 内存屏障:是一种CPU指令,用于实现以下两个主要目的:
      • 保证特定操作的执行顺序:防止屏障前后的指令进行重排
      • 保证变量的内存可见性:确保屏障前的写操作在屏障后的读操作可见
    • 通过插入读屏障和写屏障,volatile确保在读取volatile变量之前的所有操作完成,且结果对后续的读取可见;写入volatile变量后的操作不会被重排到写操作之前,示例如下:
      • 理论上,最终x和y的值可能是 (0,1), (1,0), (1,1),但由于volatile的使用,不会出现 (0,0),因为每个线程对a或b的写入在另一个线程读取之前已经完成和可见
      • 情况 (1, 0)
        • 线程B 执行 b = 1 完成后的写内存屏障确保 b 的更新对所有其他线程可见
        • 线程A 在执行 x = b 时,必须通过读内存屏障,确保看到 b 的最新值(即1)。但在此之前,a 可能还未被 线程B 读到,所以 y 可能仍是0
      • 情况 (0, 1)
        • 线程A 执行 a = 1 完成后的写内存屏障确保 a 的更新对所有其他线程可见
        • 线程B 在执行 y = a 时,必须通过读内存屏障,确保看到 a 的最新值(即1)。但在此之前,b 可能还未被 线程A 读到,所以 x 可能仍是0
      • 情况 (1, 1)
        • 如果 线程A 和 线程B 的写操作(a = 1 和 b = 1)都完成,并且各自的写内存屏障生效之后,对方线程的读操作(x = b 和 y = a)发生。这意味着每个线程都能看到对方的变量更新,结果就是 (1, 1)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
volatile int a = 0, b = 0;
int x = 0, y = 0;

// 线程A
Thread A = new Thread(() -> {
a = 1; // A1: 写操作,后面跟着写内存屏障
// ---- 写屏障 (确保a的写入对所有线程可见,且之前的写操作不会被重排到屏障后面)
x = b; // A2: 读操作,前面有读内存屏障
// ---- 读屏障 (确保读取b时获取的是最新值,且之后的读操作不会被重排到屏障前面)
});

// 线程B
Thread B = new Thread(() -> {
b = 1; // B1: 写操作,后面跟着写内存屏障
// ---- 写屏障 (确保b的写入对所有线程可见,且之前的写操作不会被重排到屏障后面)
y = a; // B2: 读操作,前面有读内存屏障
// ---- 读屏障 (确保读取a时获取的是最新值,且之后的读操作不会被重排到屏障前面)
});

在单例模式等场景中,volatile常被用于确保对象创建过程的安全性,防止对象未完全构造就被其他线程访问

18. 单例模式

  • 单例模式是一种设计模式,用于确保一个类只有一个实例,并提供一个全局访问点
  • 在 Java 中,单例模式的实现主要有几种方式:饿汉式、懒汉式(DCL双重检查锁定实现)、静态内部类和枚举方式

18.1 饿汉式

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
/**
* 饿汉式单例
*/
public class Hungry {

// 私有构造函数防止外部实例化(虽然反正了多线程并发对单例的破坏, 但还是有可能被反射破坏单例模式)
private Hungry() {
}

// 内部创建类的实例
private static final Hungry instance = new Hungry();

// 全局访问点
public static Hungry getInstance() {
return instance;
}

// 使用反射破坏饿汉式单例模式
public static void main(String[] args) throws Exception {
Class<?> clazz = Hungry.class;
Constructor<?> constructor = clazz.getDeclaredConstructor();
constructor.setAccessible(true);
Hungry instance1 = (Hungry) constructor.newInstance();
Hungry instance2 = Hungry.getInstance();
System.out.println("instance1 == instance2: " + (instance1 == instance2)); // 输出false,单例被破坏
}
}

18.2 懒汉式-DCL实现

  • DCL懒汉式单例 是在需要时才创建实例,利用双重检查锁定机制确保只创建一个实例,同时使用 volatile 关键字防止指令重排,确保线程安全
    • 通过在私有构造器中使用同步代码块和标识量来防止反射破解。然而,由于反射机制可以绕过私有构造器的限制,所以即使在构造器中使用了同步代码块和标识量,也无法阻止反射机制创建新的实例
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
/**
* DCL 懒汉式单例
*/
public class LazyMan {

private static volatile LazyMan instance = null;

private static boolean key = false;

// 即使在私有构造器里添加同步代码块, 反射也能破坏单例模式 => 使用反射获取类的私有构造器的引用
// 尝试通过设置一个标识量 key 防止反射破坏单例模式 => 还是能使用反射获取到实例来修改类中的标识量 key
private LazyMan() {
synchronized (LazyMan.class) {
if (key == false) {
key = true;
} else {
throw new RuntimeException("不要试图使用反射破坏异常");
}
}
System.out.println(Thread.currentThread().getName() + " ok");
}

// 双重检测锁模式 简称 DCL 懒汉式
public static LazyMan getInstance() {
if (instance == null) {
// 加锁
synchronized (LazyMan.class) {
if (instance == null) {
instance = new LazyMan();
/**
* 此步骤非原子操作, 对于指令重排问题 => volatile 解决
* 1、分配内存空间
* 2、执行构造方法,初始化对象
* 3、把这个对象指向这个空间
*
* 就有可能出现指令重排问题
* 比如执行的顺序是1 3 2 等
* 可以添加volatile保证指令重排问题
*/
}
}
}
return instance;
}

// 使用反射破坏 DCL 懒汉式单例
public static void main(String[] args) throws NoSuchMethodException, IllegalAccessException,
InvocationTargetException, InstantiationException, NoSuchFieldException {

// 反射获取标识量
Field key = LazyMan.class.getDeclaredField("key");
key.setAccessible(true);

// 反射获取私有构造器的引用
Constructor<LazyMan> declaredConstructor = LazyMan.class.getDeclaredConstructor(null);
declaredConstructor.setAccessible(true); // 无视了私有的构造器

// 使用反射获取的构造器创建实例
LazyMan lazyMan1 = declaredConstructor.newInstance();
key.set(lazyMan1, false); // 绕过标识量的限制
LazyMan instance = declaredConstructor.newInstance();

System.out.println(instance); // com.thr.singleton.LazyMan@1540e19d
System.out.println(lazyMan1); // com.thr.singleton.LazyMan@677327b6
System.out.println(instance == lazyMan1); // false
}
}

18.3 静态内部类

  • 使用静态内部类可以达到懒加载的效果,并且由于类加载机制保证了实例的唯一性和线程安全性
    • 还是防止不了反射,因为还是有私有构造器
1
2
3
4
5
6
7
8
9
10
11
public class Holder {
private Holder() {}

private static class InnerClass {
private static final Holder INSTANCE = new Holder();
}

public static Holder getInstance() {
return InnerClass.INSTANCE;
}
}

18.4 枚举-防止反射破坏单例

  • Java的枚举提供了一种简洁的方式来实现单例

    • 枚举自带防反射和防序列化破坏的功能
    1
    2
    3
    4
    5
    // java.lang.reflect.Constructor.java 源码
    // 可以看到在使用反射获取的构造器创建实例的源码底层设计了禁止通过反射创建枚举对象
    // 如果是枚举类型,就会抛出异常
    if ((clazz.getModifiers() & Modifier.ENUM) != 0)
    throw new IllegalArgumentException("Cannot reflectively create enum objects");
    • 使用枚举不仅简单,而且由于Java虚拟机从根本上保证了每个枚举常量的唯一性,因此通过枚举实现的单例模式也是线程安全的
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
// enum 本身就是一个 Class 类
public enum EnumSingle {
INSTANCE;

public static EnumSingle getInstance() {
return INSTANCE;
}
}

class Test {
public static void main(String[] args) throws NoSuchMethodException, IllegalAccessException, InvocationTargetException, InstantiationException {
EnumSingle instance1 = EnumSingle.INSTANCE;
// 查看枚举类的源码, 找到构造器, 尝试用反射获取
/*
protected Enum(String name, int ordinal) {
this.name = name;
this.ordinal = ordinal;
}
*/
Constructor<EnumSingle> declaredConstructor = EnumSingle.class.getDeclaredConstructor(String.class, int.class);
declaredConstructor.setAccessible(true);

// 使用反射获取的构造器创建实例
// 报错: java.lang.NoSuchMethodException: com.ogj.single.EnumSingle.<init>()
EnumSingle instance2 = declaredConstructor.newInstance();
System.out.println(instance1);
System.out.println(instance2);
}
}

19. CAS

19.1 概述

  • CAS(Compare-And-Swap)是一种用于实现同步原语的技术,广泛用于多线程编程中实现无锁的并发算法

    • 锁-Free机制:不依赖传统的锁机制(如互斥锁、读写锁)来同步线程的访问,而是通过原子操作来保证代码的安全执行
  • 操作元素:CAS涉及三个基本操作数

    • **V (内存位置)**:需要更新的内存地址
    • **A (预期原值)**:期望内存位置的值
    • **B (新值)**:如果位置的当前值与预期相符,需要写入的新值
  • 工作原理:CAS操作会原子性地执行以下步骤

    • 读取当前值:从内存位置V读取当前值
    • 比较当前值与预期值:检查内存位置的当前值是否与预期值A相等
    • 条件更新:如果当前值与预期值相等,那么将内存位置的值更新为新值B
  • 缺点:

    • 循环时间长、开销大:如果多个线程同时尝试更新同一变量,可能导致高CPU占用,因为线程需要在循环中不断尝试
    • 仅保证单一变量的原子性:对于涉及多个变量的复合操作,CAS无法直接保障其原子性
    • ABA问题:变量在被更新前后可能会被改变多次,导致CAS认为没有变化,实际上值已经被修改过
      • eg. 变量V先从A变为B,然后又从B变回A,那么使用CAS进行检查时会认为这个变量没有被修改过,但实际上它已经被修改了两次

19.2 代码示例

  • 在 Java 中利用原子操作类实现,java.util.concurrent.atomic 包下的类例如AtomicBoolean,AtomicInteger,AtomicLong 以Atomic开头的包装类提供了 CAS 功能。它们分别用于 Boolean,Integer,Long 类型的原子性操作
1
2
3
4
5
6
7
8
9
public class CASDemo {
public static void main(String[] args) {
AtomicInteger atomicInteger = new AtomicInteger(2020);

// CAS操作:如果当前值为2020,则更新为2021
System.out.println(atomicInteger.compareAndSet(2020, 2021)); // true
System.out.println(atomicInteger.get()); // 2021
}
}
  • Unsafe类在Java中提供了一个低级别的非安全机制,包括对内存的直接操作和对CAS操作的支持
    • Unsafe提供的compareAndSwap方法直接映射到硬件的原子指令,使得Java能够利用这些底层指令来实现原子操作
1
2
3
4
5
6
7
8
9
10
11
12
13
// Unsafe.java
public final int getAndAddInt(Object var1, long var2, int var4) {
int var5;
do {
var5 = this.getIntVolatile(var1, var2);
} while(!this.compareAndSwapInt(var1, var2, var5, var5 + var4)); // 自旋锁
// 比较当前工作内存中的值 和 主内存中的值,如果这个值是期望的,那么则执行操作!如果不是就一直循环,使用的是自旋锁

return var5;
}

// 本地 native 方法
public final native boolean compareAndSwapInt(Object var1, long var2, int var4, int var5);

19.3 ABA 问题

  • 本质是 CAS 操作只能检查变量当前的值是否与预期的值相同,但它不能检测在操作间隙内该值是否被修改过
    • 如果一个变量的值原先是A,被改变为B,然后又被改回A,使用CAS进行比较时将无法识别出变量已经被修改过
  • 举例:
    • 初始状态:小童的账户余额为1000元
    • 操作序列:
      • 线程1:尝试从账户中提取500元。它检查余额是否为1000元,并准备更新为500元
      • 线程1 成功执行,账户余额现在是500元
      • 线程2 也想从账户中提取500元。它开始时检查余额为1000元,但在它执行时,线程1 已经将余额改为500元。此时,线程2 被暂停或阻塞
      • 线程3(小童的妈妈)为账户汇入500元,余额恢复为1000元
      • 线程2 恢复执行,检查余额仍然为其记忆中的1000元,然后尝试将余额更新为500元。由于当前余额确实是1000元,CAS检查通过,余额被更新为500元
    • 结果:账户本应仅被扣款500元,最终却被错误地扣款两次,余额变为500元

19.4 解决 ABA 问题-带版本号的原子引用

  • 为了解决ABA问题,可以使用带版本号的原子引用
  • AtomicStampedReference 是Java提供的一个用于解决ABA问题的类。它通过维护一个“时间戳”(或称为版本号)来管理每个变量的版本,从而防止ABA问题
    • 每次变量更新都伴随一个版本号的增加,即使数据再次回到原始状态,版本号也会不同,从而避免ABA问题
  • 代码示例:
    • 线程a:成功地两次改变了值,并且每次操作后版本号都递增了
    • 线程b:尽管在它执行时值又回到了1,但由于它的操作基于过时的版本号1,所以它的更新操作失败
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
public class ABASolution {
public static void main(String[] args) {
// 初始化AtomicStampedReference,初始值为1,初始版本号为1
AtomicStampedReference<Integer> objectAtomicStampedReference = new AtomicStampedReference<>(1, 1);

// 第一个线程,模拟值的变更和版本号的更新
new Thread(() -> {
int stamp = objectAtomicStampedReference.getStamp(); // 获取当前版本号
System.out.println("a1->" + stamp); // a1->1
try {
TimeUnit.SECONDS.sleep(1); // 线程休眠1秒,模拟操作延迟
} catch (InterruptedException e) {
e.printStackTrace();
}
objectAtomicStampedReference.compareAndSet(1, 2,
objectAtomicStampedReference.getStamp(), objectAtomicStampedReference.getStamp() + 1);
System.out.println("a2->" + objectAtomicStampedReference.getStamp()); // a2->2
objectAtomicStampedReference.compareAndSet(2, 1,
objectAtomicStampedReference.getStamp(), objectAtomicStampedReference.getStamp() + 1);
System.out.println("a3->" + objectAtomicStampedReference.getStamp()); // a3->3
}, "a").start();

// 第二个线程,尝试基于原始的版本号进行修改
new Thread(() -> {
int stamp = objectAtomicStampedReference.getStamp(); // 获取版本号
System.out.println("b1->" + stamp); // b1->1
try {
TimeUnit.SECONDS.sleep(2); // 线程休眠2秒,等待第一个线程先行执行
} catch (InterruptedException e) {
e.printStackTrace();
}
objectAtomicStampedReference.compareAndSet(1, 6, stamp, stamp + 1);
System.out.println("b2->" + objectAtomicStampedReference.getStamp()); // b2->3
// 值看似匹配,版本号不匹配,更新操作失败。打印最终的版本号,仍为b2->3(未能更新,版本号没有变化)
}, "b").start();
}
}
  • 注意:

    • compareAndSet方法内部使用==来比较当前引用和传入的期望引用。对于Integer类型,这种比较是基于对象的内存地址,而非其数值
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    public boolean compareAndSet(V   expectedReference,
    V newReference,
    int expectedStamp,
    int newStamp) {
    Pair<V> current = pair;
    return
    expectedReference == current.reference &&
    expectedStamp == current.stamp &&
    ((newReference == current.reference &&
    newStamp == current.stamp) ||
    casPair(current, Pair.of(newReference, newStamp)));
    }
    • 自动装箱问题:
      • 在Java中,整数类型如Integer在-128到127之间使用了对象缓存机制。超出这个范围,或者在特定情况下,整数会被重新装箱成新的对象,导致即使数值相同,内存地址也可能不同
      • 在compareAndSet操作中,如果期望的引用数值是通过字面量或计算得出的新Integer对象,可能会因为对象地址不同而导致比较失败
      • 所以使用 Integer 作为泛型进行测试时,如果使用的数字大于128了,使用原子引用时就不会进行版本上升
    • 正常业务操作中,我们一般使用的是对象类型作为泛型(如 User 类),一般情况不会遇到这种情况

20. 理解各种锁

20.1 公平锁、非公平锁

  • 公平锁:
    • 确保获取锁的顺序按照线程请求锁的顺序来进行,即先到先得
    • 可以防止线程饥饿,但可能导致整体吞吐量较低,因为每次都需要在多个线程中严格排序
  • 非公平锁:
    • 允许插队,不保证请求锁的顺序,可以减少线程切换的开销,提高系统整体的吞吐量
    • 可能导致线程饥饿,即某些线程可能长时间获取不到锁
  • 用法: 在创建可重入锁时,想构造器中传入true
1
2
3
private final ReentrantLock fairLock = new ReentrantLock(true); // 公平锁

private final ReentrantLock unfairLock = new ReentrantLock(); // 非公平锁,默认为非公平
  • ReentrantLock 的构造器源码如下:
1
2
3
4
5
6
7
public ReentrantLock() {  // 公平锁
sync = new NonfairSync();
}

public ReentrantLock(boolean fair) { // 非公平锁
sync = fair ? new FairSync() : new NonfairSync();
}

20.2 可重入锁(递归锁)

  • 可重入锁允许线程进入任何一个它已经拥有的锁同步的代码块
    • synchronized 和 lock 都是可重入锁
  • synchronized关键字提供的锁是内置的Java关键字,并且是隐式的可重入锁,不用手工上锁与解锁
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
public class Demo01 {
public static void main(String[] args) {
Phone phone = new Phone();
new Thread(()->{
phone.sms();
},"A").start();
new Thread(()->{
phone.sms();
},"B").start();
}
}

class Phone {
public synchronized void sms() {
System.out.println(Thread.currentThread().getName() + "=> sms");
call(); // 再次获取同一把对象锁
}
public synchronized void call() {
System.out.println(Thread.currentThread().getName() + "=> call");
}
}
  • Lock是显式的可重入锁,必须手动地锁定和解锁
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
class Phone2 {
Lock lock = new ReentrantLock();

public void sms() {
// lock锁必须配对,否则会死锁
lock.lock();
try {
System.out.println(Thread.currentThread().getName() + "=> sms");
call(); // 再次获取同一把锁
} finally {
lock.unlock();
}
}
public void call() {
lock.lock();
try {
System.out.println(Thread.currentThread().getName() + "=> call");
} finally {
lock.unlock();
}
}
}

20.3 自旋锁

  • 自旋锁是指尝试获取锁的线程不会立即阻塞,而是采用循环的方式尝试获取锁,这样可以减少线程上下文切换的消耗,提高效率

  • 代码示例:设计一个自己的锁

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
public class SpinLock {
private AtomicBoolean lock = new AtomicBoolean(false);

// 获取锁的方法
public void lock() {
while (!lock.compareAndSet(false, true)) {
// 自旋等待直到锁被释放
// 在这里进行自旋等待意味着不停地循环,直到获取到锁
}
}

// 释放锁的方法
public void unlock() {
lock.set(false);
}
}
  • 测试类:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
public class TestSpinLock {
public static void main(String[] args) throws InterruptedException {
SpinLock spinLock = new SpinLock(); // 创建自旋锁的实例

// 线程1尝试获取锁,然后睡眠3秒,最后释放锁
new Thread(() -> {
System.out.println(Thread.currentThread().getName() + " 尝试获取锁");
spinLock.lock();
try {
System.out.println(Thread.currentThread().getName() + " 获取到锁");
TimeUnit.SECONDS.sleep(3);
} catch (InterruptedException e) {
e.printStackTrace();
} finally {
spinLock.unlock();
System.out.println(Thread.currentThread().getName() + " 释放锁");
}
}, "t1").start();

// 让主线程稍微延迟1秒,确保t1线程先运行
TimeUnit.SECONDS.sleep(1);

// 线程2也尝试获取锁,然后同样睡眠3秒,之后释放锁
new Thread(() -> {
System.out.println(Thread.currentThread().getName() + " 尝试获取锁");
spinLock.lock();
try {
System.out.println(Thread.currentThread().getName() + " 获取到锁");
TimeUnit.SECONDS.sleep(3);
} catch (InterruptedException e) {
e.printStackTrace();
} finally {
spinLock.unlock();
System.out.println(Thread.currentThread().getName() + " 释放锁");
}
}, "t2").start();
}
}
  • 运行过程:
    • t1线程首先启动,尝试并成功获取自旋锁。获取锁后,它将持有锁3秒钟,期间其他线程不能获取锁
    • t2线程随后启动,由于t1线程已经持有锁,t2线程会进入自旋状态,不断尝试获取锁,直到t1线程释放锁
    • 当t1线程释放锁后,t2线程立即获取锁,然后也保持3秒后释放

20.4 死锁

  • 死锁是多个线程在执行过程中因争夺资源而造成的一种僵局

  • 代码示例:背

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
public class DeadLockDemo {
// 创建两个资源
static Object resource1 = new Object();
static Object resource2 = new Object();

public static void main(String[] args) {
new Thread(() -> {
synchronized (resource1) {
System.out.println(Thread.currentThread().getName() + " 持有资源1,试图获取资源2");
try {
Thread.sleep(100);
} catch (InterruptedException e) {
e.printStackTrace();
}
synchronized (resource2) {
System.out.println(Thread.currentThread().getName() + " 获取资源2");
}
}
}, "Thread-1").start();

new Thread(() -> {
synchronized (resource2) {
System.out.println(Thread.currentThread().getName() + " 持有资源2,试图获取资源1");
try {
Thread.sleep(100);
} catch (InterruptedException e) {
e.printStackTrace();
}
synchronized (resource1) {
System.out.println(Thread.currentThread().getName() + " 获取资源1");
}
}
}, "Thread-2").start();
}
}
  • 检测死锁:

    • jps(Java Virtual Machine Process Status Tool):
      • 用于查看在系统中运行的Java进程
      • 命令:jps -l(列出系统中所有Java进程的PID和主类的全名)

    image-20240513214925881

    • jstack:
      • 用于生成Java虚拟机当前时刻的线程快照(堆栈跟踪)
      • 命令:jstack [pid](pid是通过jps查到的Java进程ID)
      • 死锁信息通常出现在输出的最后部分,标识为Deadlock

    image-20240513214900923

排查问题的方法:日志、堆栈信息

20.5 乐观/悲观锁

  • 在Java中,乐观锁和悲观锁是用于管理并发操作中数据一致性和完整性的两种策略

  • 悲观锁:假设最坏的情况,即认为数据在被读取的同时,一定会有其他线程来尝试修改这些数据

    • 因此,悲观锁在数据被读取时立即对其进行锁定,直到事务完成才释放锁。这种锁的主要目的是避免数据被其他事务修改
    • 在Java中,悲观锁可以通过synchronized关键字或Lock接口实现的各种锁(如ReentrantLock)实现
  • 乐观锁:基于数据不会被频繁修改的假设,每次去更新数据时,它都会假设没有其他线程对这些数据进行修改

    • 乐观锁通常会使用版本号或时间戳来实现
    • Java 中使用Atomic类(如AtomicInteger, AtomicReference)提供的原子操作实现乐观锁
  • 使用场景比较:

    • 悲观锁更适合写操作多的场景,可以避免数据更新的冲突

    • 乐观锁适用于读操作多的场景,减少了锁的开销,可以提高查询性能,但需要处理更新失败的情况